

GeminiとPerplexityは、ほぼまったく異なるパイプラインで商品を見つけます。Geminiは商品フィード、Merchant Center、そして新たに普及しつつあるUniversal Commerce Protocol(UCP)に依存します。一方Perplexityは、クロール可能なページと、ほかのサイトでどれだけ言及されているかに依存します。それでも両者が確認する中核シグナルは同じです。完全なスキーマ、価格と在庫の一致、そして実在するレビューです。まず1つだけ直すなら、売れ筋SKUでフィードパリティを備えた、サーバーサイドレンダリングのProduct JSON-LDを優先してください。
要点:
- GeminiとPerplexityでの可視性を確保するため、完全なスキーマ、価格の一致、毎日のフィード更新を備えた、サーバーサイドレンダリングのProduct JSON-LDを優先してください。
- 信頼シグナルによって商品がエージェントの結果から外れるのを防ぐため、特に売上の大きいSKUで在庫と価格の不整合を修正してください。
- AIエージェントのインデックス対象から商品が気付かないうちに外れることを防ぐため、クライアントサイドでのスキーマ注入や、厳格すぎるbotブロック対策は避けてください。
- シミュレーションツールを使ってスキーマの不足を特定し、カタログ全体に更新を展開する前に、影響の大きい商品で修正をテストしてください。
- 属性の充足率や在庫不一致などの運用指標を継続的に追跡し、AIエージェントでの可視性を維持・改善してください。
GeminiとPerplexityはどう商品を見つけるのか(そして、なぜそれですべてが変わるのか)
Geminiのショッピング結果は、たまたまクロールしたページではなく、データパイプラインから生成されます。Merchant Centerフィードから情報を取得し、それをGoogleのShopping Graphと照合し、ストアが対応していれば、UCPエンドポイントを直接クエリするケースも増えています。フィードにGTINが欠けている、価格が古い、または不承認としてフラグ付けされている場合、商品ページの見栄えがどれほど良くても、Geminiはその商品を表示しません。
Perplexityはショッピングエンジンというより、リサーチアシスタントに近い動き方をします。ライブのWeb検索を実行し、実際のHTMLを読み取り、そのページ上のスキーマを解析し、独立系サイト・レビュー・フォーラムで商品がどれだけ言及されているかを重視します。 PerplexityはライブWeb検索と第三者サイトの引用を重視します。そのため、メディア掲載がまったくなく、ページ上のスキーマも薄い商品は、価格がより不利でも編集面での露出が優れた競合商品に負けることがあります。
最終的には、どちらのエージェントも、買い物客がページを読むような形ではなく、構造化データに依存しています。 エージェントは構造化フィード、商品スキーマ、インデックス済みのカタログデータを参照し 、「$50未満」や「金曜までに配送」といった買い物客の条件と照合します。違いが出るのは次の点です。
- Gemini は、フィードの網羅性、Merchant Centerの整備状況、UCPプロトコル対応を重視します。
- Perplexity は、クロール可能なHTML、ページ単位のスキーマ、第三者サイトの引用を重視します。
- 両方とも Productスキーマ、Offerデータ、在庫状況、レビュー集計スコアを確認します。
- Gemini はデータベースクエリに近く、 Perplexity はライブのリサーチ処理に近いです。
優先順位付けで重要なのはここです。これらのエージェントが実際に求めるものは約80%重なっています。整ったスキーマ、正確なフィード、正当なレビューは、どちらにも有効です。
優先チェックリスト:スキーマ、フィード、在庫、レビュー
この順番で進めてください。各項目が次の項目の前提になっており、先を飛ばすと後で手戻りが発生するだけです。
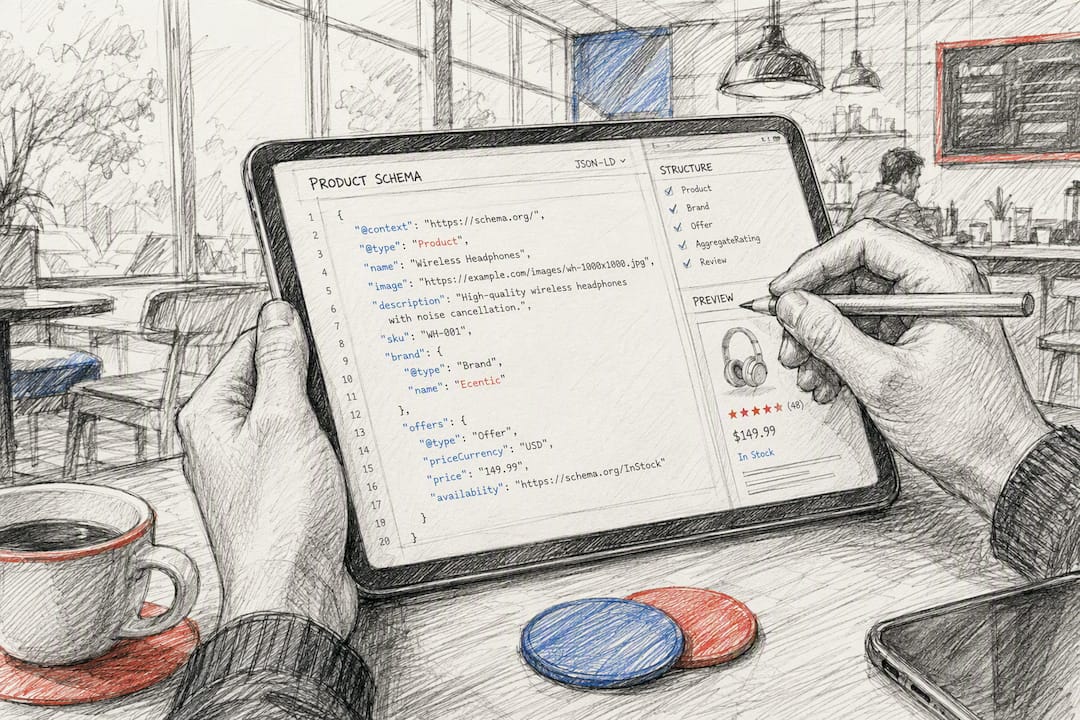
- サーバーサイドでレンダリングされるProduct JSON-LDを実装してください。 売上上位SKUにはすべて、
name,description,sku,brand,offers,aggregateRating,image、加えてGTINまたはMPNのいずれかを、生の HTML レスポンスに含める必要があります。ページの読み込み後に挿入する方法では不十分です。エージェントが確実に解析するには、完全な Product の構造化データをサーバー側でレンダリングする必要があります。項目が一つ欠けているだけで、商品が検討対象から完全に外れてしまうこともよくあります。 - 価格をどこでも一致させてください。 フィード、商品詳細ページ、購入手続きで同じ価格を表示する必要があります。エージェントはフィード、PDP、購入手続きの価格を照合するため、不一致は丸め誤差ではなく信頼性の欠如として扱われます。
- 少なくとも毎日フィードを更新してください。 動きの速いカテゴリ、アパレルのサイズ、限定ドロップ、フラッシュセールでは、よりリアルタイムに近い更新が必要です。 毎日更新は最低ラインであり。目標ではありません。
- リアルタイムの在庫状況を公開してください。 対象の
Availabilityスキーマを正確に設定し、カタログAPIエンドポイントを提供できるなら提供してください。UCP互換エンドポイントを公開しているマーチャントは、まだ対応している競合が少ないため、それだけで早期の発見性で優位に立てます。 - 分類体系を標準化し、カテゴリ属性を埋めてください。 サイズ、素材、色、フィット感など、カテゴリで求められる属性は、自由記述の説明文に散在させるのではなく、漏れなく一貫して存在している必要があります。
- 公開する
MerchantReturnPolicyとShippingDeliveryTimeスキーマを公開する。 この2つは常に後回しにされがちですが、エージェントは「返品できるか」「金曜までに届くか」といった買い物客の質問に答えるためにこれらを使います。
このプロセス全体は、全カタログではなく、売上の高い商品から始めてください。まず売上上位20%のSKUを監査すると、目に見える変化を早く出せるうえ、残りのカタログ全体へ自動化を広げるためのテンプレートにもなります。
実務のヒント ここでは、見た目の再設計より構造化データの品質のほうが常に重要です。スキーマが完璧なら、見た目が古い商品ページでも、マークアップが雑な美しいデザインのページよりおすすめされやすくなります。エージェントが評価するのは配色ではなくデータレイヤーだからです。
Shopify vs. WooCommerce:実装手順とよくある落とし穴
上のチェックリストはプラットフォームを問いません。実行方法は別です。
お使いの Shopifyでは、まず利用プランが新しいエージェント対応ストアフロント機能をサポートしているか確認してください。そのうえで、テーマがJSON-LDをサーバーサイドでレンダリングしているか、ページ読み込み後にクライアントサイドで挿入するアプリ任せになっていないかを確認します。商品フィードは、独自のスケジュールで動くサードパーティのエクスポートではなく、Shopifyの管理画面からMerchant Centerへ直接同期してください。CDNとファイアウォールのルールも確認が必要です。bot対策設定によっては、エージェントのクローラーがデフォルトでブロックされ、エラーメッセージも出ないままPerplexityの結果から外れることがあります。
お使いの WooCommerceでは、Google Tag Managerだけに依存する方法よりも、サーバーサイドのPHPスキーマプラグインやテンプレートへの直接埋め込みを優先してください。商品フィードの自動化は、本当に信頼できる仕組みを構築することが重要です。手動のCSVエクスポートはすぐに古くなり、そのズレこそがフィード整合性を損なう原因になります。カタログ規模が許す場合は、カタログAPIエンドポイントを公開し、UCPへ直接問い合わせるエージェントがフィード更新サイクルを待たずに在庫情報へアクセスできるようにしてください。
両プラットフォームで繰り返し見られるミスは、主に次の3つです。
- クライアントサイドのみでのスキーマ挿入。 初回ページ読み込み後に発火するタグは、多くのエージェントクローラーでは完全に認識されないことがあります。多くのクローラーはブラウザのようにJavaScriptを実行しないためです。
- フィード遅延による在庫不一致。 48時間ごとに更新されるフィードでは、すでに売り切れている商品が在庫ありとして表示され続けることが頻繁に発生します。
- 過剰に厳しいbot対策レイヤー。 CAPTCHAによる制限や厳格な
robots.txtルールは、スクレイピング対策として設計されていても、推奨表示を狙っているエージェントそのものをブロックしてしまうことがよくあります。
無料のJSON-LDスキーマジェネレーターを使えば、本格導入にエンジニアリング工数を投入する前に、マークアップ構造が正しいかを素早く検証できます。また、修正が機能したと思い込む前に、自社でも 構造化データチェックリスト を使ってページサンプルを確認してください。
エージェント可視性のテストと測定
スキーマとフィードを修正するだけでは不十分です。修正が機能した証拠と、トラフィック損失につながる前にリグレッションを検出できる再現性のある方法が必要です。
- まずシミュレーションを実行してください。 UCP Playgroundのようなツールで優先SKUをテストし、各クエリに対してエージェントが価格、在庫状況、引用データを正確に返しているか記録してください。
- 手動クエリで妥当性を確認してください。 価値の高いSKUを10〜15件選び、GeminiとPerplexityに直接問い合わせたうえで、回答をライブのPDPとフィードと比較してください。
- 分析をエージェント流入元ごとに分けてください。 perplexity.ai、chatgpt.com、copilot.microsoft.com(一般的なエージェント経由のリファラー元)など既知のリファラー向けにGA4セグメントを作成し、取得可能なプロトコルレベルのリファラーにはUTMタグを使用してください。
- 運用健全性の指標を毎週追跡してください。コンバージョン数だけを見ないようにしてください。
| 指標 | わかること |
|---|---|
| フィード不承認率 | 現在Geminiから見えなくなっている商品数 |
| 属性充足率 % | カタログが完全なスキーマ対応にどれだけ近いか |
| 在庫不一致インシデント数/週 | 更新頻度が実際に維持できているか |
| エージェント経由のカート追加率 | 露出が増えているだけでなく、実際にコンバージョンにつながっているか |
AIショッピングトラフィックを正しく追跡する ことで、この取り組みは単発の修正ではなく、予算会議でも説明可能な継続プログラムへ変わります。
推測よりシミュレーションが有効な理由
多くのマーチャントは、自社商品がAIエージェントから見えていないことに、原因を特定するのではなく、来るはずのトラフィックが来ないことで初めて気付きます。ecenticは、この順序は逆だと考えています。どのスキーマ項目、どのフィード属性、どの整合性ギャップが除外の原因なのかを、推測にエンジニアリング時間を費やす前に把握すべきです。
シミュレーション主導のテストでは、問題箇所を正確に特定できます。管理された環境で商品クエリを実行すれば、エージェントが実際に見ている内容を確認でき、見えているはずだという想定には頼りません。この違いが、今週中に上位20SKUの正しい5項目を修正できるか、それとも来四半期に大規模なスキーマ更新を実施して機能することを期待するだけになるかを分けます。この手法を採用した顧客からは、シミュレーションで特定された具体的な問題を解決した後、AI経由の訪問数と売上が測定可能な形で増加したという報告があります。
効果的な運用手順は、まず売上上位SKUに対して重点的なシミュレーションを実行し、修正によってエージェントの回答が実際に変わることを確認したうえで、同じ修正パターンをカタログ全体へ自動展開することです。検証ステップを省略すると、同じスキーマを二度作り直す事態になりがちです。
— Xhurian
推測に頼らずGeminiとPerplexityに推奨される方法
すべてのSKUについて手動でエージェントに問い合わせる方法はスケールしません。また、一般的なSEOアドバイスでは、どの項目が推奨表示を妨げているのかはわかりません。ecenticは、実際の商品ページに対してエージェントクエリをシミュレーションし、どこに問題があるのかを平易な言葉で提示します。たとえば不足している aggregateRating、フィード価格とPDP価格の不一致、エージェントが静かに無視しているスキーマ項目などです。

このプラットフォームは Shopify または WooCommerceに直接接続し、 商品情報をスキャンして、エンジニアリングのバックログを経由せずにワンクリックで公開できる修正を生成します。また、UCP Playgroundへ直接アクセスできるため、変更前後でGeminiとPerplexityが上位SKUにどう反応するかをテストできます。これにより、修正が機能したと想定するのではなく、実際のエージェント挙動を測定できます。
まずは無料スキャンを実行し、最も影響の大きい修正点を特定したうえで、カタログ全体へ展開する前にライブのエージェントクエリで検証してください。
FAQ
商品レコメンドではPerplexityのほうがGeminiより優れていますか?
どちらが明確に優れているというわけではありません。GeminiはフィードとMerchant Centerのデータが整っている場合に最も効果を発揮し、一方Perplexityはサードパーティの引用に裏付けられた構造化ページを重視します。そのため、どちらが適しているかは、現在どのシグナルをストアがより適切に扱えているかによって変わります。
ショッピング用途でのChatGPTとGeminiの違いは何ですか?
ChatGPTとGeminiはどちらも構造化されたカタログデータに依存していますが、Geminiのショッピング結果はGoogleのMerchant CenterフィードとShopping Graphにより強く結び付いています。一方、ChatGPTはPerplexityのアプローチに近く、一般的なWebクロールや引用情報への依存度が高くなっています。
GeminiとPerplexityでは別々の最適化が必要ですか?
基本的には不要です。両エージェントは、クリーンなスキーマ、正確なフィード、実際のレビューなど、基盤となる要件の約80%を共有しているため、それらを修正すれば大半は両方に対応できます。
商品フィードはどのくらいの頻度で更新すべきですか?
安定したカタログでも最低でも毎日の更新が必要です。アパレルや限定ドロップのように在庫変動が激しい商品では、売り切れ商品を在庫ありとしてエージェントが引用しないよう、リアルタイムに近い更新が求められます。
変更を公開する前に、GeminiやPerplexityから商品がどう見えているかをテストできますか?
はい。UCP Playgroundのようなシミュレーションツールで優先SKUを実行すると、本格展開する前に、現在のスキーマとフィードデータをエージェントがどのように解釈しているかを正確に確認できます。