

AI検索でコレクションページを直す最も手早い方法は、各ページを page_category (または pageCategories)の値と、それに対応する必須フィルター(例: categories: ANY('Home & Garden'), で定義し、AIショッピングエージェントの閲覧リクエストが、広くて雑多な結果ではなく、適切に絞り込まれた関連商品を返せるようにすることです。これに加えて、フィードデータ(明確なタイトル、完全な GTIN、良質な画像)を整備し、 Google Cloud の AI Commerce ドキュメント、Microsoft の Copilot Shopping ガイダンス、およびシミュレーションツールで確認してから公開してください。
要点:
- 閲覧リクエストではクエリが空になるため、pageCategories とリクエストのフィルターは大文字小文字を含めて完全に一致している必要があります。一致しないと、無関係な商品が結果に含まれる可能性があります。
- カテゴリフィルター付きの再利用可能な単一デプロイメントを使い、実行時に各ページに対応する plp_category コンテキストを渡します。ワイルドカードページはカテゴリ制限を通さないようにルーティングしてください。
- Copilot Shopping は Microsoft Merchant Center フィードに依存するため、掲載対象に含まれやすくするには、具体的なタイトル、該当する場合は完全なGTIN、高品質な画像、マッピング済みの商品カテゴリを整備してください。
- 変更後は、実際の閲覧リクエストをテストし、is_filter_applied、products_list、total_result を確認してください。未検証の修正をそのまま拡大適用しないために、シミュレーションと段階的な比較が役立ちます。
AIのブラウズリクエストはテキスト検索とどう違うのか
テキスト検索とブラウズは別の処理であり、コレクションページの成否は、AIエージェントがどちらを実行していると判断するかにかかっています。テキストクエリでは、空でない query フィールドが送られます。つまり、購入者またはエージェントが具体的な語句を入力し、エンジンはその語句との関連性で順位付けします。ブラウズは異なります。空のqueryで実行され、 pageCategories とフィルタに全面的に依存して、そのページに何を表示すべきかを判断します。これはGoogle CloudのAI commerce searchドキュメントにも記載されています。
この違いが重要なのは、購入者がAIエージェントにブラウズを任せる場面が増えているためです。たとえば、アシスタントに「狭いリビングに合うラグを探して」と頼んだ場合、エージェントはその語句をサイト内の検索ボックスに入力しているのではなく、ブラウズ型のリクエストを発行し、コレクションページ側が何を含めるべきかをすでに把握している前提で動きます。コレクションページは、いわば第二の第一印象になります。AIエージェントがカテゴリをサンプルし、そのカタログをさらに推奨する価値があるかを判断する場になるのです。
もし pageCategories または対応するフィルタが欠けていると、リクエストには絞り込みの基準がありません。その結果、広すぎて関連性の低い商品情報が既定で返されます。これはコピーや画像の問題ではなく、バックエンド設定の問題です。
- テキストクエリには具体的な検索語句が入り、その語句との関連性で順位付けされます。
- ブラウズリクエストには空の検索クエリが入り、対象範囲の定義はカテゴリフィールドとフィルタフィールドに依存します。
- カテゴリフィールドが欠けている、または一致していないと、ブラウズ結果は広すぎて関連性の低い商品情報に流れます。
そのため、AIエージェント向けのコレクションページ最適化は、コンテンツ作業ではなく、まずエンジニアリング作業として始まります。
コレクションページを機能させるフィールドとフィードシグナル
この修正は主に、正しいフィールドを正しい場所に設定し、それらの整合性を保つことです。以下の順序で進めてください。
- 設定する:
page_categoryまたはpageCategoriesを、ページ自体とリクエストペイロードの両方に設定します。 Google CloudのAI commerce searchドキュメントでは、ページカテゴリ識別子と一致するフィルタの両方がそろっていない限り、ブラウズ結果は広すぎるままだと明示されています。 同ドキュメント. - フィルタでは同一の値を参照させる。それが
attributes.pageCategoriesでも、categoryidフィールドでも同じです。「Outdoor Furniture」というタグが付いたページでも、フィルタが別のカテゴリ文字列を参照していると、エラーが出なくても静かにスコープ設定に失敗します。 - コンテキスト変数を使う。たとえば
plp_categoryのようなものをプラットフォームのフィルタ設定内で使い、実行時には同じ変数をリクエストコンテキストで渡します。これにより、デプロイメントごとにフィルタを個別にハードコードしなくても、1つのデプロイメントで多くのコレクションページに対応できます。 - 大文字・小文字の違いを必ず確認してください。 フィールド名とフィルタ変数は大文字・小文字を区別するため、
PageCategoryとpageCategoryがスタック内の別の箇所で食い違うことは、結果が過度に広がる一般的で見えにくい原因です。 - タクソノミーを正式にマッピングしてください。 Googleの
Product.categoryフィールドは現在、CategoryCodeオブジェクトをサポートしており、自社の内部商品タイプを Googleの公式タクソノミーにマッピングできます。これにより、AIショッピングエージェントは自由記述のカテゴリ文字列から推測する代わりに、フィルタや順位付けに使える一貫したカテゴリシグナルを得られます。 - ページネーションとファセットのシグナルを追加する。たとえば
page,page_size、ファセット件数を追加し、レスポンスフラグとしてis_filter_appliedのような値も記録します。これにより、後からスコープ設定が実際に行われたことを確認でき、行われたはずだと決めつけずに済みます。 - 構造化データまたはメタデータを付与する 。商品とそのコレクションページの対応関係を明示的にマッピングすることで、下流のモデルやカタログ学習はページレイアウトだけから推測するのではなく、その関係を認識しやすくなります。
ポイント: カタログ全体に手を付ける前に、まずトラフィックの多いコレクションページを1つ、最初から最後までチェックしてください。ページのカテゴリ値、フィルタのカテゴリ値、リクエストペイロードのコンテキスト変数を同じ場で確認します。食い違いは通常、この3つのうち2つの間にあるズレに潜んでいます。
すべてのコレクションページに対応する1つのデプロイメントを構築する
カテゴリごとに個別の検索設定を用意する必要はありません。実務的なパターンとして、 商品リストページの実装ガイダンスで示されているのは、検索エンジンとカテゴリフィルター定義を結び付けた再利用可能な1つのデプロイメントまたはエクスペリエンスを構築し、リクエスト時にコンテキストだけを差し替えながら、同じデプロイメントをすべてのコレクションページから呼び出すことです。
- 検索エンジンとカテゴリフィルター定義を組み合わせたデプロイメント(多くの場合、
deployment_idをキーにしたもの)を作成します。 - 各ブラウズリクエストでは、空のクエリ、
deployment_id、コレクション名、ページ番号、さらにそのページ固有のplp_categoryの値をそのページ向けに渡すコンテキストオブジェクトを送信します。 - フィルター自体が、コンテキストオブジェクトで使う変数名と同じ名前を参照していることを確認してください。デプロイメントが読み取るのは、その変数であって、ハードコードされたカテゴリ文字列ではありません。
- カテゴリフィルターの上にハイブリッドランキングまたはセマンティックランキングを重ね、絞り込まれた集合内での商品順序に自然言語の関連性が引き続き反映されるようにしてください。良いページを作る役割をフィルターだけに任せないことが重要です。
- 「すべての商品」ページやワイルドカードページは意図的に扱ってください。バイパス用のフィルター設定に切り替えるか、カテゴリフィルターパターンの外へ明示的にルーティングし、より狭いページ向けのカテゴリ制約を誤って引き継がないようにします。
- 確認する項目は、
products_list,total_result、ファセット数、およびis_filter_appliedです。デプロイメント変更のたびにレスポンスログで確認し、意図どおりにフィルターが発火したことを確かめてください。
このパターンはきれいにスケールできます。コレクションページが多い小売事業者でも、ページごとに別々の検索設定を維持する代わりに、適切に設定した1つのデプロイメントに異なるコンテキスト値を渡して使い分けられます。
ページ上でのAIエージェントの挙動をシミュレーションして測定する方法
設定変更に意味があるのは、それが機能したと確認できる場合だけです。そしてその確認方法は、AIショッピングエージェントが実際にたどるのと同じようにブラウズ経路をテストすることです。
- ブラウズモードのAPI呼び出しを直接実行する。コレクションページが実際に送信するコンテキスト値を使い、
is_filter_applied,products_list、total_resultをレスポンスで確認して、リクエストが想定したカテゴリに本当に限定されたかを確かめてください。 - エージェントシミュレーションツールまたは制御されたエージェントクエリを使う 。特定のカテゴリプロンプトでどの商品が選ばれるかを確認し、変更前後の結果のスナップショットを残してください。推測ではなく、具体的なビフォーアフター比較ができます。
- 少数のKPIを追跡する: ブラウズリクエスト全体におけるフィルター適用率、AI経由として計測されるセッション、単一の商品ページではなくコレクションページを参照するエージェント引用の割合、そしてそれによって生じたコンバージョンの上昇です。
- 定期的に再スキャンを自動化する。特にカタログ更新やタクソノミー変更の後は重要です。新しい商品カテゴリや属性名の変更によって、前週までは正常に機能していたフィルターが気付かないうちに壊れることがあります。
- 初期結果は慎重に扱ってください。 少数のシミュレーションクエリや数日分のエージェントトラフィックは、小さなサンプルにすぎません。段階的な展開やシンプルなA/B比較を行えば、変更が本当に効果を生んだかをカタログ全体へ適用する前に判断するための、より確かな根拠が得られます。
AI経由のショッピングトラフィックの大きな変動は、人々のAI検索ツールの使い方に関するより広い変化と時を同じくして起きています, 検索行動の変化に関する報道 でも指摘されているとおり、比較対象となるベースライン自体が動いていることを忘れてはいけません。
ECチームがこの展開で見誤りがちな点
多くのチームは、まずコンテンツの問題として捉え、コレクションページのコピーを書き換えたりFAQブロックを追加したりします。しかし実際の阻害要因は、ほとんどの場合、バックエンド内のカテゴリフィールドの欠落または不一致です。これは修正可能な機械的問題ですが、コピー変更は進んでいる実感があり、フィルター監査はそう感じにくいため、コンテンツ作業の陰に埋もれてしまいます。
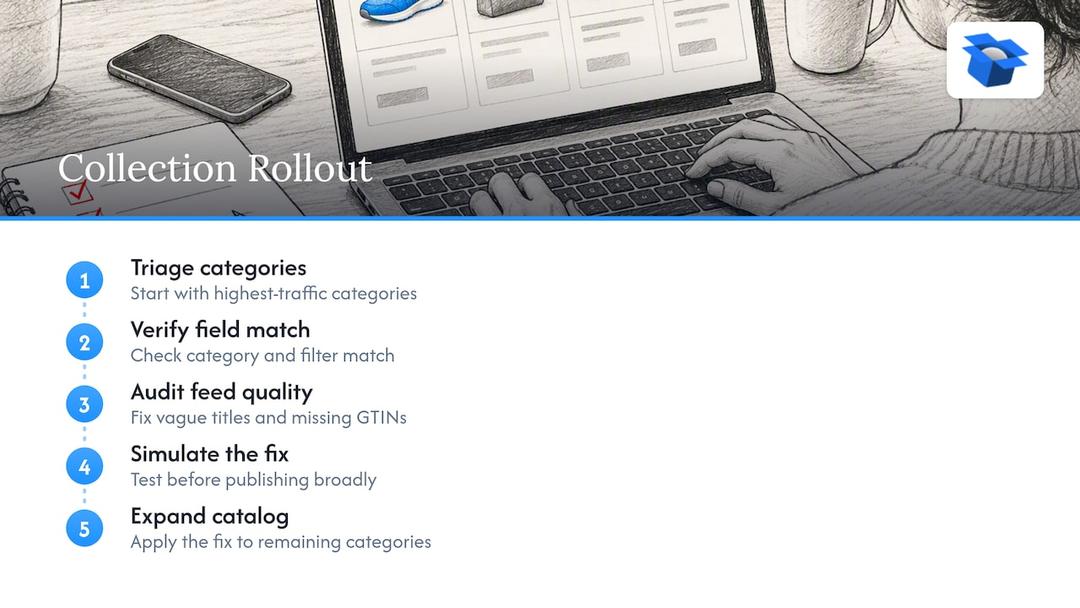
より良い進め方はこうです。まずトラフィックの多いカテゴリを優先して切り分け、 page_category とフィルターの対応がそのカテゴリ群で合っているかを検証し、その後で残りのカタログへ広げます。少数カテゴリに絞った修正でも、サイト全体でフィルターを壊している共通パターンが見つかることが多く、残りのページを1つずつ同じようにデバッグする手間を避けられます。
そのエンジニアリング上の修正に加えて、商品フィードの品質確認も行ってください。コレクションページの絞り込みが完璧でも、タイトルが曖昧でGTINが欠けていれば、AIショッピングエージェントが推奨できる情報はほとんどありません。広く公開する前にシミュレーションで修正の効果を証明してください。変更が役立ったと期待するのと、実際に役立ったと把握するのとの差です。
— Xhurian
ecenticがコレクションページの実装の修正と検証をどう支援するか
このようなガイドを読んだ多くのチームが直面するギャップを埋めるために、当社はプラットフォームを構築しました。 page_category とフィルターが一致すべきだと知ることと、カタログ全体で本当に一致しているかを確認することは、別の問題です。私たちは、ChatGPT や Gemini などの AI ショッピングエージェントが商品情報をどう評価するかをシミュレーションし、どの商品を選ぶのかと、その理由を示します。そのうえで、わかりやすい診断結果と、優先順位付きの修正案を提供します。

- 商品情報に関するインサイトを提供する無料の初回スキャンを実施しています。
- 診断結果をワンクリックで公開できる仕組みに変換し、 ShopifyとWooCommerceへ反映できるため、修正がバックログに放置されません。
- 継続的な再スキャンによってAIによる選択率を追跡し、カタログ変更の影響を継続的に監視できます。
まずは 無料スキャン で自社のコレクションページの現状を確認するか、 Compete、Scale、Dominateプラン をご比較ください。ライブのエージェント挙動に対してUCPプロファイルを検証するチーム向けには、 UCP Playground で任意のストア設定を直接テストできます。
FAQ
AIはどのようにデータを収集するのですか?
AIショッピングエージェントは、Copilot Shoppingのレコメンドを支えるMicrosoft Merchant Centerフィードなど、すでに公開しているフィードや構造化データに加え、サイト上のカテゴリメタデータやページレベルのシグナルから商品データを収集します。AI専用の別個のデータパイプラインが存在するわけではなく、従来のショッピング広告を支えている同じフィードやタクソノミーフィールドが、AIレコメンドシステムにも利用されています。
AIにおける「30%ルール」とは何ですか?
その用語を見かけた場合は、業界標準のベンチマークとして扱うのではなく、元の文脈を直接確認することをおすすめします。
注目すべき主要なAIショッピングプラットフォームは?
固定された一覧があるわけではなく、実際にユーザーが商品閲覧や購入に利用している主要なAIショッピングエージェントを追跡することが重要です。これにはChatGPT、Gemini、Claude、Perplexityに加え、MicrosoftのCopilot Shoppingのような小売特化型のサービスも含まれます。それぞれ商品フィードやカテゴリシグナルの解釈方法がやや異なるため、一般的なランキングに頼るよりも、自社の商品情報を各サービスで実際にテストするほうが有効です。
ショッピングに関連するAIの主なカテゴリは何ですか?
eコマースの文脈で重要なのは、会話型ショッピングエージェント(ChatGPTやGeminiなど)、コマースプラットフォームに組み込まれたAI検索・閲覧エンジン、そして商品フィードの背後で動作するレコメンドやランキングモデルです。マーチャントにとって重要なのはAIの学術的な分類ではなく、コレクションページやフィードが、それぞれのシステムが確認する技術要件を満たしているかどうかです。たとえば、閲覧リクエストが依存するページカテゴリとフィルターの整合性などが該当します。
コレクションページがAIエージェント向けに正しく設定されているかをテストするには?
実際のコンテキスト値を使用してbrowseモードのAPIコールを実行し、 is_filter_applied と total_result が適切なスコープを反映しているかを確認したうえで、同じカテゴリに対するAIエージェントのシミュレーション結果と比較してください。両者が一致しない場合、その不整合は通常、ページ設定とリクエストペイロード間で一致していないカテゴリフィールドまたはフィルター変数に起因しています。