

シミュレーション主導のレディネス監査を、複数エンジンをまたぐ勝率テストと組み合わせて実行しましょう。この組み合わせなら、一般的なSEOチェックリストでは見落とされがちな点、つまり ChatGPT、Gemini、Claude、Perplexity が実際にどの商品を推薦するか判断する際に使う機械可読なシグナルを捉えられます。Ecentic はこのアプローチを Shopify と WooCommerce の事業者向けに提供しており、測定するシグナルそのものを修正できる点から、最初に検討すべきプラットフォームです。
今これが重要な理由は次のとおりです。
- 価格や在庫状況が JavaScript の読み込み後にしか表示されないページは、エージェントにスキップされます
- CatalogReady のような レディネス監査ツール なら、ページを 0〜100 で採点し、何が壊れているのかを正確に示してくれます
- 原因を最速で特定するには、勘ではなく無料スキャンを使うことです
今日、まず1回監査を実行してください。以下では、何を測定し、なぜ重要なのかを説明します。
重要ポイント
AIショッピングエージェントに推薦されるには、説得力のある商品コピー以上に、ページ、フィード、スキーマ全体で機械可読な整合性を保つことが重要です。
| ポイント | 詳細 |
|---|---|
| コピーより先に構造を修正する | 説明文を書き直す前に、価格と在庫状況をサーバーサイドで表示し、Product と Offer の JSON-LD を完成させてください。 |
| クローラーのアクセスを確認する | robots.txt と llms.txt で OAI-SearchBot、PerplexityBot、および同様のエージェントクローラーが許可されていることを確認してください。 |
| あらゆる情報面を突き合わせる | ページ、フィード、スキーマ全体で価格と在庫状況を照合してください。不一致があると商品は対象外になります。 |
| 複数エンジンでテストする | 修正前後でChatGPT、Perplexity、Geminiに同一クエリを実行し、スコア上昇ではなく実際に選ばれるようになったかを確認します。 |
| 継続的な診断にはecenticを活用する | ecenticは決定論的な準備状況監査を実行し、そのまま貼り付けられるJSON-LD修正を提供するとともに、ShopifyとWooCommerceストア向けにエージェント経由の訪問を追跡します。 |
AIエージェントシミュレーターとは? なぜマーチャントに必要なのか
AIショッピングエージェントシミュレーターは、ChatGPT、Gemini、Perplexityが商品ページを評価するプロセスをそのまま再現し、エージェントが何を見て、何を無視し、なぜ競合商品を選んだのかをレポートするツールです。これは、エンジニアがマルチエージェントワークフローのデバッグに使う汎用エージェントテストフレームワークとは別カテゴリの製品です。ショッピングエージェントシミュレーターの役割はひとつだけです。自社の商品情報がAI購入者との接点で選ばれる状態にあるかをマーチャントに知らせることです。
その接点は3つの段階で発生します。 エージェント型コマースプロトコルの分析によると、まず取得段階です。エージェントのクローラーがページを取得し、そこから構造化データを解析できるか。次に信頼性です。レビュー、ポリシー、価格表示が、エージェントが確認するすべての面で一致しているか。最後にアクションです。在庫を確認し、途中で行き止まりにならずに購入手続きを完了できるか。どれか1つでも失敗すると、人間には魅力的に見えるコピーであっても、その商品は候補から外されます。
シミュレーターでは、JSON-LDが正しく解析されるか、価格がフィードと一致しているか、特定の日に特定エンジンで特定クエリに対して商品が表示されるかを測定できます。ただし、恒久的な上位表示を保証することはできません。エージェントの出力はモデル更新、競合の変化、クエリ表現によって変動するため、すべてのシミュレーションは保証ではなくスナップショットとして扱う必要があります。
AIエージェントシミュレーターを評価する方法
AIシミュレーションアプリとして販売されているツールのすべてが、ショッピングエージェントにとって重要な項目を実際にテストしているわけではありません。準備状況スコアを信頼する前に、次の5つの領域をカバーしているか確認してください。
- スキーマとサーバーサイドレンダリングデータの検証。 ツールはProductおよびOfferのJSON-LDについて、タイトル、GTINまたはSKU、価格、通貨、在庫状況を確認し、それらの項目がJavaScript実行後だけでなく静的HTMLにもレンダリングされていることを検証する必要があります。 AgentMintによる商品ページ構造の分析 では、多くのAIクローラーは静的HTMLしか取得しないため、クライアントサイドのみのデータは認識されないと指摘しています。
- クローラーアクセスの確認。 robots.txtとllms.txtを読み取り、OAI-SearchBotやPerplexityBotなど特定ボットがブロックされていないことを確認する必要があります。
- 各接点における情報の整合性。 信頼できる監査ツールは、ページ上の価格と在庫状況を商品フィードおよびスキーママークアップと照合し、不一致によって商品が即座に除外される箇所を検出します。
- 決定論的な診断。 曖昧な「SEOを改善しましょう」という助言ではなく、ルールIDやそのまま貼り付けられるJSON-LDパッチを提供するツールを選びましょう。オープンソース監査ツールのCatalogReadyは、ページを0〜100で採点し、すべての問題を具体的に修正可能なルールに紐づけます。
- 根拠付きのマルチエンジンシミュレーション。 単一エンジンでのテストでは、ChatGPTがページをどう認識するかしか分からず、鮮度や引用を異なる重みで評価するGeminiやPerplexityについては何も分かりません。
ヒント: ベンダーには、準備状況スコアが決定論的(ルールベースで再現可能)なのか、モデル生成による推定なのかを確認してください。決定論的スコアは翌日も同じ結果を再現できますが、モデル生成型はページに変化がなくても実行ごとに結果が変動する可能性があります。
商品ページで勝率テストを実行する方法
このプロトコルは1日以内で実施でき、すぐに活用できる修正前後の比較結果を得られます。
- JavaScriptなしでページを取得する。 生のHTMLを取得し、タイトル、価格、在庫状況、識別子がレンダリング後のDOMだけでなく静的レスポンスにも含まれていることを確認してください。
- ProductとOfferのJSON-LDを検証する。 priceCurrency、price、availability、GTINまたはSKUが存在し、ページ上で購入者に表示される内容と一致していることを確認してください。
- robots.txtとllms.txtを確認する。 エージェントが依存するクローラーをブロックしていないことを確認し、まだ設定していなければllms.txtを追加してください。 StoreSEOの分析 では、これをShopifyマーチャント向けで最も効果の高い技術的修正のひとつと位置付けています。
- 決定論的監査を実行して結果をエクスポートする。 ルールIDとそのまま貼り付けられる修正内容を取得し、サーバーレンダリングとスキーマのパッチを直接適用します。
- 修正前後で、ChatGPT、Perplexity、Geminiに対して同じ商品クエリを実行する。 エージェントが商品を推奨したか、無視したか、競合商品を選んだかを記録してください。
- 準備状況スコアの変化とエージェント経由の訪問数を合わせて追跡する。 スコア変動は先行指標にすぎません。本当の評価基準は、エージェント流入から実際の訪問やコンバージョンが発生したかです。
| 指標 | 記録内容 |
|---|---|
| 準備状況スコア | 修正前後の0〜100スコアと、解消されたルールID |
| エンジン別勝率 | 同一クエリに対してChatGPT、Perplexity、Geminiが商品を推奨したかどうか |
| エージェント経由の訪問 | エージェントからのリファラートラフィックとして計測されたセッションを週次で追跡 |
| コンバージョン | エージェント由来セッションから完了した注文 |
この種のテストに関する実務的な見解は、ひとつの点で一致しています。準備状況スコアの変化だけでは何も証明できないということです。本当に確認すべきなのは、同じクエリに対するエージェントの実際の推奨結果が、修正前後で変わったかどうかです。
ヒント: 修正前後のクエリは、同じ時間帯に、まったく同じ文言で実行してください。自社側で何も変えていなくても、エージェントの回答はセッションごとに変わることがあります。そのため、一組のクエリを比較しただけでは何も証明できません。各エンジンで各クエリを三回実行し、過半数を占めた結果を採用してください。
エージェント対応チェックリストに含めるべき項目
他の作業に着手する前に、すべての商品ページでこのリストを確認してください。順番は修正の容易さではなく、エージェント推奨を妨げる頻度順です。
- 商品名、ブランド、識別子(GTIN、MPN、SKU)がHTMLとJSON-LDの両方に存在する
- 総額価格と通貨がサーバーサイドでレンダリングされ、フィードと完全一致している
- 在庫状況が最新で、ページ、スキーマ、フィード間で一致している
- 少なくとも1枚の商品画像が、視覚表示だけでなくスキーマ内でも参照されている
- レビュー件数と評価が、サードパーティウィジェット内に埋もれず構造化データとして公開されている
最も多くのエージェントを通過可能にする6つの修正を、頻度順で挙げると次のとおりです。価格と在庫状況をJavaScriptで読み込むのではなくサーバーサイドレンダリングすること、完全なProductおよびOffer JSON-LDを追加すること、フィードと実ページの価格を一致させること、配送・返品ポリシーを商品ページからリンクすること、よくある購入者の質問に答える短いFAQブロックを追加すること、そして比較コンテキスト(素材、サイズ感、類似バリエーションとの違いなど)をエージェントに提供することです。影響度と工数で優先順位を付けてください。スキーマとサーバーレンダリングの修正は半日程度で取得処理そのものを通過可能にしますが、比較コンテキストは作成に時間がかかる一方で、エージェントに認識されるかどうか自体を左右することはまれです。
主要AIエージェントシミュレーターを価格と機能の深さで比較
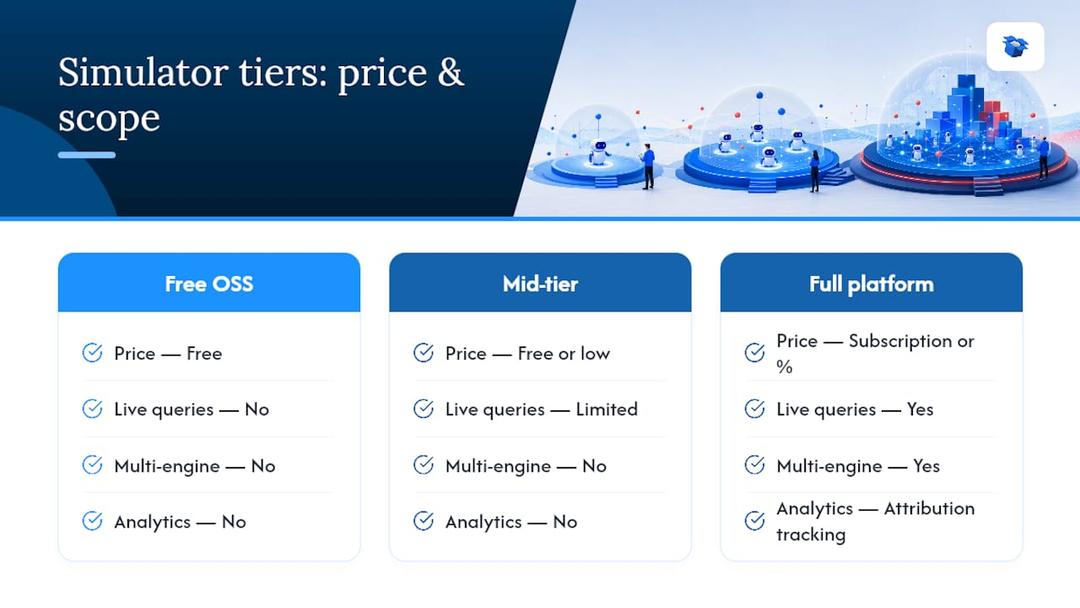
シミュレーターツールは3つの階層に分かれます。CatalogReadyのような無料オープンソース監査ツールは、APIキー不要で完全オフライン動作し、決定論的な0〜100スコア、ルールID、JSON-LDパッチを提供します。そのため、コストも登録の手間もなく、当日中に対処可能な出力を得られる最初の一手として有力です。一方で範囲には限界があります。ローカル監査ツールはスキーマやサーバーレンダリングを確認できますが、ChatGPTやPerplexityに対してライブクエリを実行し、現時点でエージェントが実際に何を推奨しているかまでは確認できません。
中位層のチェッカーは、多くが無料または低価格のWebツールで、単一ページをスキャンし、欠落したスキーマ項目やブロックされたクローラーなど明らかな問題を検出します。簡易的な健全性チェックには有用ですが、通常はクロスエンジンテストや継続的モニタリングまでは対応していません。
Ecenticのようなフルプラットフォームは、オープンソースツールの決定的な診断チェックに加え、ライブのマルチエンジンシミュレーション、実際のエージェント経由訪問を追跡するアトリビューション分析、ShopifyやWooCommerceへのワンクリック修正公開を組み合わせています。料金体系は、月額固定またはエージェント流入に起因する注文割合ベースで、無料スキャンから始められます。階層間の違いは、単一チェックの精度ではありません。1ページを手動で確認するだけなのか、カタログ全体に対して継続的な診断を行い、エージェント流入が実際にコンバージョンしているかまで追跡するのかという違いです。
ツールのインターフェースはデータを活用しやすいか
次の商品公開までに修正へ落とし込めなければ、準備状況スコアに意味はありません。優れたシミュレーターは、技術出力の羅列ではなく、各ルールIDの横に平易な説明を添え、問題の大きい順に優先順位付きリストとして結果を表示します。
CatalogReadyのようなオープンソースのコマンドライン診断ツールを使うには、ターミナルの操作とJSON出力を直接読むことに慣れている必要があります。技術担当者には問題なくても、自分でストアを運営する個人のDTC販売事業者には負担になります。Webベースのプラットフォームは、細かな制御の一部と引き換えにダッシュボードを提供します。目立つ場所に準備状況スコア、その下に不合格となったチェック項目が並びます。テーマファイルへ手動でパッチをコピーする代わりに、修正を適用するボタンやコードスニペットを利用できます。
本当に役立つツールと、見た目だけ整っているツールを分けるインターフェース上の要素は2つあります。1つ目は、 なぜ チェックに失敗したのかを、該当フィールドやマークアップ行まで含めて表示するか、それとも単に失敗した事実だけを示すかです。2つ目は、修正後に監査全体を最初からやり直さず、同じチェックだけ再実行できるかです。小さな修正のたびにフルスキャンを強制するツールでは、5分の修正が20分作業になり、多くのマーチャントは3回目あたりで使わなくなります。単発監査ではなく継続利用を前提にしたプラットフォームは、「全体を再スキャン」と「この1ルールだけ再確認」を分けている傾向があり、SKU数が増えるほどその差は大きくなります。
これらのシミュレーションは実際のエージェント行動にどこまで近いのか
率直に言えば、構造的な障害を見つけるには十分現実的ですが、正確な順位予測には不完全です。スキーマ、クローラーアクセス、価格整合性を確認するシミュレーターは、実際のエージェントが通過するのと同じ機械的なゲートをテストしています。JSON-LDに必須項目が欠けていたり、robots.txtがPerplexityBotをブロックしていたりする場合、その失敗は決定論的です。シミュレーションでも本番でも、毎回同じ結果になります。
シミュレーションが曖昧になるのは、最終的な推奨段階です。エージェントは、鮮度、購入者クエリの表現、競合状況などを、セッションやモデル更新ごとに変化する形で評価します。今日商品が表示されたクエリでも、自社側に変更がなくても明日は表示されないかもしれません。だからこそ、1回の勝敗テストではほとんど意味がありません。前述のように、各エンジンで同じクエリを3回実行し、多数結果を追跡するほうが、単発チェックより実態に近い評価になります。
ChatGPT、Gemini、Perplexityは同じ動作をしないため、マルチエンジンテストも重要です。特にPerplexityは、エージェント向け信頼性シグナルの研究によると、新鮮で引用可能なコンテンツを好み、明確な出典表示を高く評価します。この研究では、ページに引用、引用文、統計情報を追加すると、生成回答での表示性が最大40%向上する可能性があるとされています。単一エンジンしかテストしないシミュレーターでは、この差異を完全に見逃し、気付かないまま誤ったシグナルに最適化してしまいます。
サポートとドキュメントに期待すべきこと
CatalogReadyのようなオープンソースツールには、GitHubのREADMEとコミュニティ活動程度しかありません。コード内のルール定義を読んだりJSON-LDエラーを自力でデバッグできるなら問題ありませんが、修正が期待通りに動かなかった場合に相談相手がいない状態になります。
商用プラットフォームはこの点で大きく差があり、その違いは修正がうまく反映されないときに最も顕著に現れます。このカテゴリで優れたドキュメントとは、単なる機能紹介ページではありません。各ルールIDが何を確認しているのかを具体的に説明し、修正前後のJSON-LD例を示し、一般的なEC SEOではなくエージェント行動を理解したサポート窓口があることです。PerplexityBotとOAI-SearchBotの違いを説明できるサポートチームは、単に一般的なチケット対応を行うチームより価値があります。
どのプラットフォームを導入する前にも、更新頻度を確認してください。エージェント行動はプロバイダーのモデル更新で変化します。ChatGPT ShoppingやGeminiの商品検索の現行バージョンに追随していないドキュメントを持つツールは、古い地図で動く標的を追っている状態です。 構造化データチェックリスト のように、schema.orgの変更に合わせて実装ガイダンスを最新化し続ける姿勢は、基盤となるエージェントの変化速度が通常のSEOガイダンスより速いため、他の多くのソフトウェアカテゴリ以上に重要です。
実際の修正はどのようなものか
成功した修正に共通するパターンは、ほぼ毎回同じです。人間の購入者には完成して見えるページでも、具体的かつ修正可能な1つの欠落によって、エージェントには見えていなかったというケースです。JavaScript呼び出し後にしか表示されない価格。ページのスキーマと異なる在庫状態を示すフィード。GTIN欠落によって、小売間の価格比較をエージェントが完了できないケースなどです。
SEO向けの修正を推測で行うのではなく、まず明確なルールに基づく診断を実施した販売事業者は、実際の障害がコンテンツではなく構造にあると、一貫して確認しています。商品説明を書き直しても、クローラーがアクセスできない問題が解決することはまれです。商品フィードと公開ページの価格を整合させることは、問題の解決につながります。ecenticの顧客からは、この種の診断と、その結果に基づく修正を行った後、AI経由の訪問数と総売上の両方で、測定可能な増加が報告されています。これは、より広く見られる傾向とも一致します。まず機械が読み取るデータ層を修正すると、エージェントが提供内容をようやく読み取れるようになるため、推奨される割合も改善する傾向があります。
この教訓は個別ケースを超えて一般化できます。ページ、フィード、スキーマ間の不一致は、弱いコピーよりも大きな失格要因です。その不一致を修正する前にキーワード単位のコンテンツ変更へ注力するマーチャントは、間違ったレイヤーを最適化しています。
本当に成果につながるのは何か
AIショッピング表示性に関する多くの助言は、今でも新しい略語を付けた従来SEOのように扱っています。しかし実際は違います。従来SEOは数か月かけて蓄積される関連性シグナルを重視します。一方、エージェント表示性は、今日の午後にも修正できる構造的正確性を重視します。JSON-LDが解析できるか、価格がフィードと一致しているか、クローラーがページに到達できるか、といった点です。これは根本的に別の問題であり、多くのマーチャントはまだ誤った問題を解こうとしています。
見落とされがちなのは、コンテンツではなく整合性です。コピーが優れていても、フィードの価格とページの価格が一致しないだけで競合に負けることがあります。エージェントはその不一致を信頼性の欠如と見なし、次へ進みます。自社データソース間の構造的不一致は、どれだけ説得力ある文章を書いても解決できません。
まず1つだけ実施するなら、コピーを1文字も触る前に決定論的監査を行ってください。監査で問題として検出された箇所を修正し、フィードを整合させたうえで、複数エンジンで同じクエリをテストし、結果が実際に変わったか確認します。勝率テストを省略すると、根拠ではなく思い込みで最適化することになります。UCP Playgroundが存在するのは、準備状況スコアだけではエージェントの実際の推奨が変わったか分からないからです。「スコアは改善した」と「エージェントに選ばれた」の間にあるギャップこそ、多くのマーチャントが早々に確認をやめてしまうポイントです。
準備状況スコアを実際のエージェント流入につなげる
独自監査を実行すれば、どこに問題があるかは分かります。しかし、カタログ全体へ修正を適用し、その効果を証明する段階で多くのマーチャントは時間切れになります。ecenticはこのループを完結させます。ShopifyやWooCommerceへ直接接続し、前述した決定論的診断をカタログ全体へ実行し、曖昧な提案ではなくルールID付きのそのまま貼り付けられるJSON-LDパッチを提供します。

監査に加えて、ecenticのUCP Playgroundでは、ChatGPT、Gemini、Claude、Perplexityが任意の公開商品ページをどう評価するかをシミュレーションし、変更を本番反映する前にテストできます。ワンクリック公開で修正をストアへ直接反映でき、アトリビューション分析ではエージェント経由の訪問や注文を追跡できるため、準備状況スコアだけでなく実際に勝率が変化したかを確認できます。このワークフローを実施した顧客からは、AI経由訪問と売上の両方で測定可能な増加が報告されています。
Shopifyでストアを運営している場合は、 プラットフォーム別セットアップ を使えば数分で接続できます。WooCommerceマーチャントには、 同じ統合フローが提供されます。まずは 商品情報の無料スキャン を実行し、どこから修正を始めるべきか判断する前に現在の準備状況スコアを確認してください。
参考情報
この記事を超えて実践的にテストしたい場合は、CatalogReadyが、貼り付け可能な修正付きの無料オフライン0〜100準備状況監査ツールを提供しています。 CrawlConsoleの商品ページチェックリスト では、エージェントが確認する具体的な項目を解説しています。AIのECにおける役割をより広く理解するには、 BabyLoveGrowthのAI活用事例まとめ が有用な出発点になります。
FAQ
AIショッピングエージェントシミュレーターとは?
ChatGPT、Gemini、Perplexityが商品ページをどのように読み取り評価するかを再現し、エージェントが何を見て、何を無視し、なぜ競合商品を選ぶ可能性があるのかを表示するツールです。
無料のAIエージェントシミュレーターは小規模ストアでも十分か?
CatalogReadyのようなオープンソース監査ツールは、単一ページの確認には適しており費用もかかりません。ただし、フルプラットフォームのようにライブのマルチエンジンクエリ実行や継続的なエージェント流入追跡は行えません。
準備状況監査はどのくらいの頻度で再実行すべきか?
価格、在庫、スキーマを変更した後は必ず監査を再実行し、最低でも毎月実施してください。ChatGPT、Gemini、Perplexityのモデル更新に伴ってエージェント行動も変化するためです。
シミュレーターで商品が推奨されることを保証できるか?
どのツールも恒久的な順位を保証することはできません。エージェントの推奨結果はクエリ表現やモデル更新で変化するため、シミュレーションは長期保証ではなくスナップショットとして扱ってください。
ecenticはShopifyとWooCommerceの両方に対応しているか?
はい。ecenticはShopifyおよびWooCommerceストアへ直接接続し、監査後はワンクリック公開で修正を適用できます。