

AI向けA/Bテストとは、商品情報のバリエーションを統制された条件で比較し、ChatGPT、Gemini、Claude、Perplexityが、それぞれどのバージョンを実際に買い物客に推薦するかを確認することです。まずは主力SKUを数件、これらのエージェントに対してシミュレーションし、テストを始める前に、ほとんどのテストを壊す2つの要因、つまり不足している構造化データと古いフィード項目を修正します。エージェントが何を表示するかに最も大きく影響するのはこの3つのシグナルなので、まずは構造化データの完全性、フィードの鮮度、レビューの厚みを優先してください。
要点:
- priceValidUntil、deliveryTime、merchantReturnDays などの構造化データ項目は欠落または古くなっていることが多く、エージェントの推薦に大きく影響します。
- フィードの鮮度とリアルタイム更新は重要です。価格や在庫状況が古いと、商品情報の不一致や販売機会の損失につながる可能性があります。
- エージェントのシグナルは主にデータ駆動であるため、テストでは無作為なコピー修正ではなく、特定の構造化データやフィードの変数を切り分けて検証するべきです。
- AIショッピングエージェントごとに表示位置や属性に対する選好が異なるため、バリエーションは複数モデルでテストする必要があります。
- 本番展開前にシミュレーションベースの監査を実施すれば、構造化データの不足をすばやく特定し、AIでの可視性を高め、購買意欲の高い買い物客からの流入を増やせます。
Shopify・WooCommerceストアでエージェント重視のA/Bテストが重要な理由
AIショッピングエージェントは、人のようには閲覧しません。読み取るのは、構造化データ、フィードの正確性、そしてレビューや編集記事での言及といった第三者による裏付けなど、機械可読なシグナルです。人の買い物客には魅力的に見えるページでも、基盤となるマークアップが不十分なら、エージェントには見えない存在になりえます。
Columbia Business Schoolはシミュレーションによる購買セッションを実施し、 掲載位置、バッジ、価格、評価が、エージェントがどの商品を選ぶかを左右することを明らかにしました。モデルごとに好みも異なっていました。GPT-4.1は結果セットの左側に配置された商品に寄る傾向があり、Claudeは中央、Geminiは右側を好みました。これだけでも、すべてのエージェントに共通する単一の「最良」な商品情報は存在しないと分かります。最適解はモデルごとに異なり、だからこそ勘ではなくテストが有効なのです。
マーチャントにとっての見返りは現実的です。AIエージェント経由で流入するトラフィックは、ページに到達する前にすでに推奨を受けているため、購買意欲が高い傾向があります。ただし条件があります。商品詳細ページが、エージェントの説明内容を裏づけなければなりません。たとえばエージェントが「30日以内なら返品無料」と案内しても、ページ上の見える文言やスキーマでそれを確認できなければ、その時点で売上機会を失います。
エージェントが特に重視するもの:
- Product、Offer、Reviewの各スキーマタイプにまたがる構造化データの完全性
- フィードの鮮度。つまり、価格と在庫状況がサイト上の最新情報と一致していること
- レビュー、シンジケートされた評価、編集記事での掲載による独立した裏付け
何をテストすべきか:属性、スキーマ項目、サイト外シグナル
どんな実験でも始める前に、変更する価値がある項目とシグナルを正確に絞り込んでください。行き当たりばったりのコピー修正をテストしても工数を無駄にします。一方で、エージェントが実際に解析する項目をテストするなら無駄にはなりません。
- 主要なJSON-LD項目。 エージェントは
Product,Offer,AggregateRating、Reviewスキーマを直接読み取ります。対象となる型とその項目は、Offer,priceValidUntilです。後者は前者の中で、多くの販売事業者が思っている以上に重要です。同様に重要なのがShippingDeliveryTime.deliveryTimeやMerchantReturnPolicy.merchantReturnDaysです。 Sellarixによる36件の商品ページ監査 では、Product JSON-LDは72%のページに存在していましたが、priceValidUntilがあるページはわずか 6%、配送時間は 11%、返品日数はわずか 6% でした。監査対象のページで、この三つがすべてそろっていたものはありませんでした。 - フィードとプロトコルの健全性。 Merchant Center フィードの完全性、AI エージェントによる商取引のプロトコル(ACP、UCP、MCP)への対応状況、更新頻度は、エージェントが参照するデータと公開サイトの最新情報がそもそも一致するかを左右します。この EC 向け AI SEO 実践ガイドで詳しく説明されています。一日一回しか更新しないフィードは、テストの途中で価格が変わると、気づかないうちに実験を損なう可能性があります。
- サイト外の証拠。 レビューは、単純な星評価よりも、件数、新しさ、具体性のほうが重みを持ちます。小売パートナー全体にシンジケートされたレビューや編集記事での言及も、エージェントが相互参照できる裏付けになります。
作成する各バリアントは、この3つのカテゴリのいずれか1つだけを切り分けるべきです。変えるのはコピーではなくスキーマ、あるいはスキーマではなくコピーです。コピーを変えるならフィードの更新頻度は変えないでください。変数を混ぜると、結果を説明できなくなるのがマーチャントによくある失敗です。
AIショッピングエージェント向けA/Bテストの進め方
この種のテストは、マーケティングのスプリットテストというより、管理されたエンジニアリングの段階的展開に近いものです。結果の解釈をぶらさないための手順は次のとおりです。
- テスト対象のSKUを選び、成功条件を先に定義 カタログ全体ではなく、売上を牽引する商品を3〜5点選びます。開始前に成功指標も設定してください。AIシェア・オブ・ボイス(自社カテゴリで推奨を求められたときに、自社商品がどの程度表示されるか)、引用頻度、エージェント経由セッションからのコンバージョン上昇です。
- 単一変数のバリアントを設計 1つはスキーマ修正(たとえば
merchantReturnDays)を追加する版、説明文内の仕様の順序を入れ替える版、レビューの抜粋を強調する版を、それぞれ作成します。一つのバリエーションに二つの変更をまとめてはいけません。 - 本番公開前にシミュレーション 各バリアントを、少なくとも2つのモデルファミリーにまたがる代表的なエージェントセッションで検証します。モデル固有の偏りはこの時点ですでに十分に確認されており、あるモデルで勝つバリアントが、別のモデルでは負けることがあります。
- 本番環境では慎重に検証 シミュレーションで有力な勝ちパターンが見えたら、フィードの段階的な送信、またはプラットフォームが対応している場合はACP/UCPのサンドボックス環境を通じて展開します。初日にトラフィックの100%を切り替えるのは避けてください。
- エンジニアリングの細部を詰める ShopifyまたはWooCommerceでは、JSON-LDはタグマネージャー経由で注入するのではなくサーバーサイドでレンダリングし、エージェントやフィードが2つの版を同一商品としてまとめてしまわないよう、バリアントごとに個別のGTINを割り当ててください。さらに、エージェントにとって重要な項目がdev previewだけでなく生のHTMLレスポンス内に存在することを検証する統合テストも用意します。
プロのヒント: テーマ、フィードスキーマ、レビュー管理アプリを変更したら、そのたびにシミュレーションを再実行してください。テンプレート更新によって、数週間かけて評価を獲得したJSON-LDブロックが気づかないうちに削除されることがあります。
たとえば ecenticの商品情報機能 を使えば、不足している項目を診断し、手動監査ではなく1回の処理で修正をストアに反映できるため、ステップ5を大幅に短縮できます。
どの指標でバリアントの勝敗を判断するのか
ここでは見栄えだけの指標は意味を持ちません。重要なのは、エージェントが商品を表示したか、その表示経由の訪問がコンバージョンしたかです。
追跡すべき主要KPI:
- AIシェア・オブ・ボイス: 定義したテストプロンプト群において、競合と比べてブランドがどの程度表示されるか
- 引用頻度: エージェントが特定の商品ページや属性をどの程度参照しているか
- エージェント経由のコンバージョン率: 既知のエージェントリファラー経由で訪問したセッションのコンバージョン率。自然検索や広告トラフィックとは分けて追跡します
技術的な健全性指標も同じくらい重要です。フィードが壊れていると、本来は勝てるバリアントでも成果を失います。
- カタログ全体でのスキーマカバレッジ率
- Merchant Centerでのフィード承認率と不承認率
- 次の項目の存在率:
priceValidUntil,deliveryTime、merchantReturnDays
計測に向けて、 既知のエージェントリファラー向けGA4セグメント を設定し、perplexity.ai、chatgpt.com、copilot.microsoft.comなどを対象に、一般的な自然検索トラフィックへまとめるのではなく、そのセグメント専用のコンバージョンファネルを構築してください。
エージェント経由トラフィックのサンプル数は初期段階では小さい傾向があります。そのため、多くのテストは最初のうちは統計的に有意な結果が出ません。1週間だけ結果が横ばいでも失敗ではなくnullとして扱い、少なくとも2回分の完全なシミュレーションと本番サイクルで傾向が確認できるまでは、バリアントをカタログ全体へ展開しないでください。
よくある落とし穴、管理ポイント、実践的なヒント
テスト失敗の多くは、繰り返し発生するいくつかの問題に集約されます。
- クライアントサイドでの価格反映。 価格が初回レンダリング後にJavaScriptで読み込まれる場合、一部のエージェントは価格を認識できず、フィード価格と実際の価格にズレが生じます。
- バリアント単位の識別子不足。 GTINがバリアントごとに分かれていないと、エージェント(または自社フィード)が2つのテストバリアントを1つの商品情報に統合してしまいます。
- フィード整合性の破綻。 サイトでは1つの価格、フィードでは別の価格が表示され、エージェントはより信頼していないほうを選んでしまいます。
- 返品または配送項目の設定ミス。
MerchantReturnPolicyが実際のポリシーと一致していないと、購入者が気づいた時点で急速に信頼を失います。
商品テンプレートごとに、これらの項目がレンダリング後のDOMではなくサーバーレスポンス内に存在することを確認する自動統合テストを作成してください。テンプレート更新によって6週間分のスキーマ作業が静かに削除される前に、問題を検知できます。
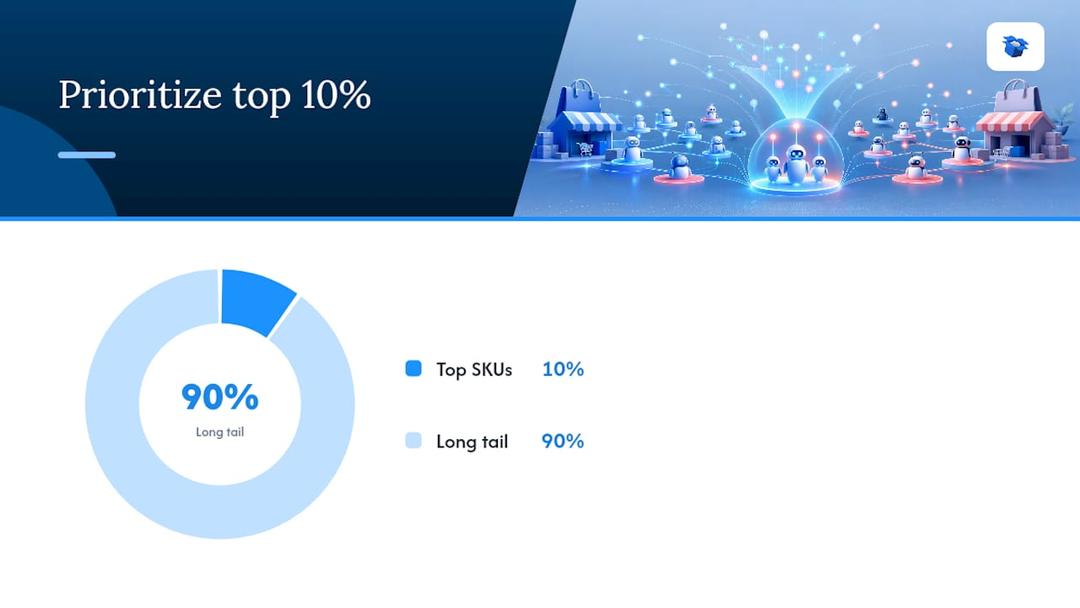
プロのヒント: 売上上位SKUを優先してください。ロングテールに手を付ける前に、まず売上ベースでカタログ上位 10% を修正してから、ロングテールに取りかかります。また、一般的な星評価依頼ではなく、「何に使いましたか?」のような具体的な質問でレビューを促してください。エージェントが実際に取得するのは、こうした利用シナリオ付きレビューです。
シミュレーション主導テストが実際に変えるもの
数十件の商品ページ監査とエージェントセッションのシミュレーションを行うと、「商品情報で勝つ」とは何かの捉え方が変わります。本能的にはコピー改善に目が向きますが、実際には、8か月間誰も確認していなかったスキーマブロック内の不足項目が原因で負けているケースがほとんどです。
各商品情報を本番公開前にエージェントセッションでシミュレーションし、数週間かかる開発チケットではなく1ステップで修正をShopifyやWooCommerceへ反映するアプローチは、不足項目が解消された後に、AI主導の訪問数やその後の売上改善に役立つ可能性があります。
— Xhurian
ecenticで最初のA/Bテストを実行
一部のプラットフォームでは、上記のワークフローを短時間で実行できるツールとして提供しています。ChatGPT、Gemini、Claude、Perplexityに対して商品情報をシミュレーションし、なぜ競合の商品情報が比較で選ばれたのかを平易な英語で説明したうえで、修正内容をワンクリックでShopifyやWooCommerceへ反映します。開発チケットやテンプレートデプロイ待ちは不要です。

手動で確認する代わりに priceValidUntil や merchantReturnDays をカタログ全体で手動確認する代わりに、エージェントに重要な不足項目を正確に特定する診断と、それを修正する自動最適化処理を利用できます。継続的な再スキャンにより、変更後に各エージェントでの選択率が向上しているかを追跡できるため、修正が機能したかを推測する必要はありません。まずは無料スキャンを実行し、実際に売上を生む3つのSKUを選び、シミュレーションを行い、勝ったバリアントを公開してください。プランは Competeプラン月額$14.90から利用でき、カタログや目標の拡大に合わせてScaleとDominateも選択できます。
FAQ
AIエージェント向けA/Bテストにはどれくらいかかりますか?
バリアントを作成済みであれば、シミュレーションサイクルはライブトラフィック量に依存しないため、1〜2日で実行できます。本番検証には通常2〜4週間かかります。多くのストアでは、エージェント経由トラフィックのサンプル数がまだ小さいためです。
これらのテストに開発リソースは必要ですか?
JSON-LDとフィードデータを編集できる担当者は必要ですが、 ecentic のようなプラットフォームを使えば、不足項目を診断し、修正を直接ShopifyやWooCommerceへ反映できるため、手動コーディングの大半を削減できます。
AIエージェントにとって重要なスキーマ項目はどれですか?
Offer.priceValidUntil, ShippingDeliveryTime.deliveryTime、 MerchantReturnPolicy.merchantReturnDays は、Productスキーマ自体は整っているストアでも監査で最も不足が見つかる3項目だと、Sellarixの監査で報告されています。
AIモデルごとに異なる商品バリアントをテストできますか?
はい。実施すべきです。シミュレーションではモデルごとの傾向が見えるため、あるエージェントで勝つバリアントが別のエージェントでは負ける場合があります。本番展開前に少なくとも2つのモデルでテストする価値は十分あります。
ecenticの料金はいくらですか?
EcenticのCompeteプランは月額$14.90から、Scaleは$44.90、Dominateは$149です。従量課金向けとして、AI起点注文ごとに3%の成果報酬オプションも利用できます。プラン契約前に無料スキャンを試せます。
関連トピックを確認