

Sì, robots.txt è il modo standard per indicare ai crawler AI se possono indicizzare le tue pagine o usarle per l’addestramento, ma la conformità è volontaria. Usa token specifici come GPTBot per bloccare i crawler di addestramento lasciando consentiti i token orientati alla ricerca se vuoi ancora che le tue pagine vengano citate nei risultati di ricerca AI. Il file non fermerà fisicamente un bot malevolo, ma tutti i principali fornitori di AI lo documentano e lo rispettano.
In breve:
- Posiziona robots.txt nella radice del dominio, crea un file separato per ogni sottodominio e scrivi User-agent e Disallow esattamente con queste maiuscole perché i nomi delle direttive distinguono tra maiuscole e minuscole.
- OpenAI separa il proprio crawler di ricerca da quello di addestramento, quindi puoi consentire le citazioni nella ricerca bloccando l’addestramento; le modifiche possono richiedere circa 24 ore.
- Il controllo di Google per l’addestramento AI non influisce sulla scansione di ricerca di Googlebot; l’esclusione per Anthropic richiede regole separate per entrambi i suoi crawler di addestramento.
- Una pagina esclusa non può mostrare il proprio tag noindex ai crawler, quindi usa direttive meta per le pagine HTML e intestazioni HTTP per PDF e immagini.
- Robots.txt non può proteggere contenuti sensibili né fermare i bot non conformi; usa l’autenticazione per i materiali privati e il blocco tramite CDN o WAF quando le richieste continuano.
Snippet robots.txt copiabili per bloccare o consentire i crawler AI
Un file robots.txt si trova nella radice del tuo dominio (yoursite.com/robots.txt), mai in una sottocartella, e ogni sottodominio deve avere la propria copia. I nomi delle direttive e i token user-agent distinguono tra maiuscole e minuscole, quindi Disallow e User-agent devono essere scritti esattamente come mostrato, anche se i percorsi che indichi possono variare in base alla configurazione del server.
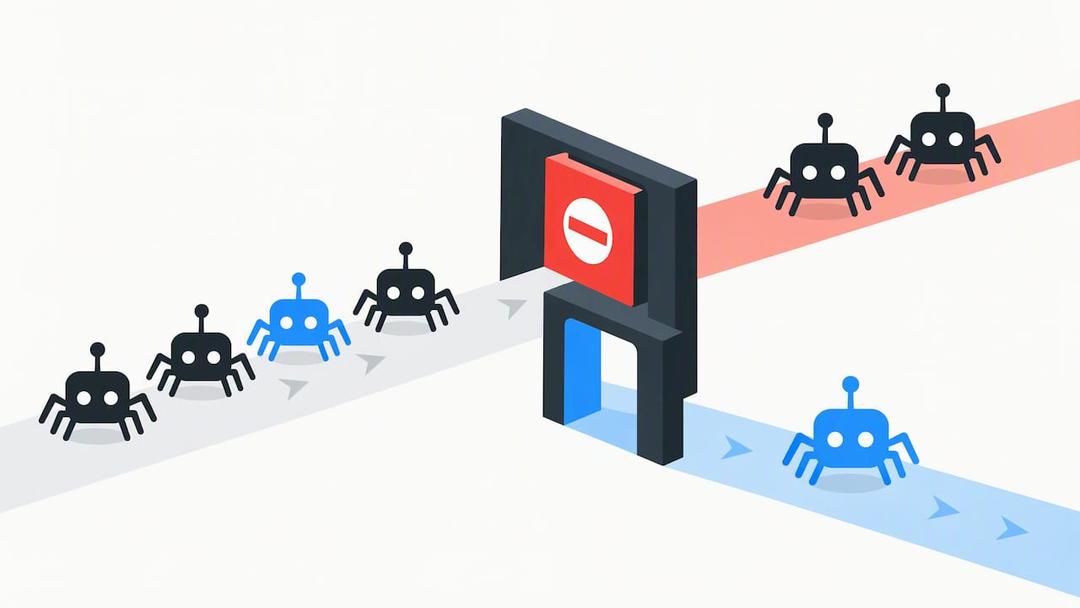
Una configurazione minima che blocca i crawler di training ma mantiene la visibilità nella ricerca è questa:
User-agent: GPTBotseguito daDisallow: /per escludere il crawler di training di OpenAI.User-agent: OAI-SearchBotseguito daAllow: /per continuare ad apparire nei risultati di ricerca di ChatGPT.User-agent: *seguito daAllow: /così i crawler generici, inclusi i motori di ricerca, continuano ad avere pieno accesso.
Per i siti che vogliono escludersi completamente dall'addestramento dell'AI, un semplice elenco di blocco di riserva ripete Disallow: / sotto ogni token di training nominato (GPTBot, Google-Extended, ClaudeBot e altri), lasciando aperto il gruppo wildcard per i motori di ricerca. Un modello conservativo “non bloccare nulla” salta del tutto i gruppi nominati e usa solo User-agent: * con Allow: /, che è lo stato predefinito se non aggiungi mai un file robots.txt.
Mantieni il file breve. Search Engine Land consiglia di negare solo i token di training specifici che vuoi escludere, invece di provare ad autorizzare esplicitamente ogni crawler che non ti crea problemi, perché gli elenchi di autorizzazione ampi sono più difficili da mantenere e più soggetti a blocchi accidentali dell'intero sito.
Suggerimento pratico: Testa ogni nuova modifica al robots.txt prima su un sottodominio di staging, perché un wildcard fuori posto può bloccare accidentalmente Googlebot insieme ai crawler AI che volevi escludere.
Come funzionano i token User-Agent e le regole di precedenza
L'interpretazione di robots.txt segue regole rigide, e sbagliarle è il modo più semplice per escludere per errore i motori di ricerca. In base a RFC 9309, i token user-agent possono contenere solo lettere, underscore e trattini, quindi i caratteri jolly all'interno del nome del token non sono validi. Devi elencare ogni crawler che vuoi raggiungere con il suo nome esatto, invece di provare a far corrispondere più nomi in una volta sola.
Alcune regole determinano quale gruppo e quale regola si applicano davvero:
- Un gruppo nominato come
User-agent: GPTBotha la precedenza sul gruppo genericoUser-agent: *per quel crawler specifico. - Quando più regole
DisallowoAllowpotrebbero corrispondere a un URL, prevale il percorso corrispondente più lungo, indipendentemente da quale regola compaia per prima nel file. - Un simbolo finale
$finale ancora una regola alla fine esatta di un percorso, permettendoti di bloccare un tipo di file specifico senza influire su un'intera directory.
Se sbagli il nome del token, anche solo di un carattere, il crawler ricade semplicemente sul gruppo wildcard invece che sulla regola che intendevi applicare.
Voci robots.txt specifiche dei fornitori da conoscere
Ogni principale provider di AI pubblica i propri token, e non sempre corrispondono direttamente a un singolo bot. OpenAI usa OAI-SearchBot per l'indicizzazione nella ricerca e GPTBot per la raccolta dei dati di addestramento, e i due sono controllati in modo indipendente, quindi puoi consentirne uno e negare l'altro. Le modifiche a una delle due direttive possono richiedere circa 24 ore per avere effetto, secondo la documentazione di OpenAI, quindi non aspettarti un cambiamento immediato nel comportamento di crawling dopo aver modificato il file.
Google usa Google-Extended come token di controllo, non come agente HTTP distinto per le richieste. Questo token stabilisce se i prodotti AI di Google possono usare i tuoi contenuti per l’addestramento e le funzionalità generative, mentre Googlebot continua a eseguire la scansione per la ricerca secondo le proprie regole.
User-agent: GPTBotconDisallow: /ti esclude dal training di OpenAI lasciandoOAI-SearchBotinvariato.User-agent: Google-ExtendedconDisallow: /ti esclude dall'uso per l'addestramento dell'AI di Google senza influire sulla normale indicizzazione nella ricerca.User-agent: anthropic-aieUser-agent: ClaudeBotcoprono i crawler di Anthropic, ed entrambi richiedono in genere unDisallowesplicito se vuoi escludere l'addestramento.User-agent: Applebot-Extendedcontrolla separatamente l'uso per l'addestramento dell'AI di Apple rispetto al principaleApplebotusato per Siri e Spotlight.- Vale la pena abbinare i crawler di Perplexity a un blocco applicato a livello edge, perché segnalazioni hanno descritto episodi di mancata conformità in cui un crawler ha continuato a recuperare pagine nonostante una regola di disallow.
Combinare robots.txt con meta tag e blocco a livello edge
Robots.txt è una richiesta, non un muro, e la documentazione ufficiale di Google conferma che il rispetto è volontario e non una misura di sicurezza vincolante. Le pagine bloccate possono comunque comparire nei risultati di ricerca come semplici URL e, poiché una regola Disallow impedisce del tutto il recupero della pagina, qualsiasi meta tag noindex che hai inserito in quella pagina non viene mai letto.
Per questo conta combinare più livelli. Le pagine HTML possono includere le direttive meta noai o noimageai per l’esclusione a livello di singola pagina, mentre le risorse non HTML come PDF, immagini e feed richiedono X-Robots-Tag come intestazione HTTP, perché non hanno un corpo della pagina in cui inserire un meta tag.
- Usa robots.txt come primo livello per i crawler ben educati che lo leggono e lo rispettano.
- Aggiungi meta tag o intestazioni
X-Robots-Tagper un controllo granulare, pagina per pagina o per tipo di file. - Usa autenticazione o protezione con password quando il contenuto è davvero sensibile, perché robots.txt non è mai stato progettato come misura di sicurezza.
- Valuta Bot Preference Sync di Cloudflare, che può anteporre direttive gestite al tuo robots.txt esistente e abbinare queste preferenze a un blocco applicato a livello edge per categoria (Search, Agent, Training), così le preferenze dichiarate e l'applicazione effettiva restano allineate.
Suggerimento pratico: Se un crawler ignora completamente il tuo robots.txt, il blocco a livello edge tramite CDN o WAF è l'unico livello che ferma davvero la richiesta.
Testare e verificare che le tue direttive funzionino
Per confermare che un crawler rispetti davvero il tuo robots.txt serve una breve checklist, non supposizioni.
- Controlla nei log del server le richieste a
/robots.txtprovenienti dagli user agent specifici dei provider che hai preso di mira e verifica che compaiano prima di qualsiasi crawl di percorsi bloccati. - Tieni conto dei tempi di aggiornamento dei provider. La documentazione di OpenAI segnala che le modifiche possono richiedere circa 24 ore per propagarsi, quindi ricontrolla dopo un'intera giornata invece che subito.
- Usa uno strumento di fetch in tempo reale o un validatore, come il checker robots.txt di BabyLoveGrowth, per confermare che la sintassi venga interpretata correttamente e corrisponda alla tua intenzione.
- Esamina i report di CDN o WAF insieme alle regole del tuo robots.txt per individuare eventuali crawler che continuano a recuperare percorsi bloccati nonostante le tue direttive.
- Configura una pagina di test mirata con una regola di disallow univoca e monitora se compare nell'output di quel provider nei giorni successivi.
Bilanciare la visibilità nella ricerca AI con l'esclusione dall'addestramento
Per i siti ecommerce, la decisione di solito dipende da tre fattori: quanta parte dei ricavi dipende dal traffico di riferimento generato dall'AI, quanto sono sensibili i contenuti dei tuoi prodotti e con quale frequenza cambia il tuo catalogo. Se le citazioni nella ricerca AI portano traffico significativo, consenti i token di ricerca e blocca solo quelli di addestramento. Se descrizioni, prezzi o immagini possono essere facilmente copiati e ripubblicati altrove, bloccare i crawler di addestramento protegge quell'investimento. I merchant che puntano sulla visibilità hanno comunque bisogno di un modo per misurare se sta funzionando, ed è qui che uno strumento di ottimizzazione dedicato trova il suo valore.
— Xhurian
Ecentic: misura e ottimizza la tua visibilità negli acquisti AI
Scegliere di consentire i token di ricerca è solo metà del lavoro. La domanda più difficile è se agenti AI per gli acquisti come ChatGPT e Gemini raccomandano davvero i tuoi prodotti una volta che possono vederli. Abbiamo creato ecentic per rispondere direttamente a questa domanda: ci colleghiamo al tuo store Shopify o WooCommerce, simuliamo come gli agenti AI valutano le tue schede prodotto e ti mostriamo esattamente dove vinci o perdi rispetto ai concorrenti.

Se il tuo obiettivo è aumentare, non ridurre, il traffico generato dall'AI, ottimizzare è meglio che bloccare. Trasformiamo la nostra diagnostica in suggerimenti concreti di riscrittura e li pubblichiamo di nuovo nel tuo store con un clic, così il divario tra “visibile all'AI” e “raccomandato dall'AI” può ridursi.
- Esegui scansioni basate su simulazioni per vedere come diversi agenti AI per gli acquisti leggono le tue schede prodotto.
- Ricevi consigli pratici in linguaggio chiaro collegati a specifiche pagine prodotto, non generici suggerimenti SEO.
- Pubblica le correzioni direttamente su Shopify o WooCommerce senza uscire dalla dashboard.
Inizia con una scansione gratuita delle schede prodotto per vedere a che punto sono oggi le tue schede prodotto.
FAQ
È legale usare robots.txt per bloccare i bot AI?
Sì, pubblicare un file robots.txt ed elencare eventuali identificatori dei crawler che scegli di non autorizzare è una parte standard e legale della gestione di un sito web secondo il Robots Exclusion Protocol. Esprime semplicemente le tue preferenze di scansione; da solo non ha alcun potere legale di applicazione, quindi abbinalo all'autenticazione per tutto ciò che necessita davvero di protezione.
Esiste una chat o un forum per discutere del comportamento dei bot AI?
Non esiste una chat ufficiale unica gestita dai fornitori AI per le domande su robots.txt, ma ogni fornitore pubblica la propria documentazione, come la panoramica dei crawler di OpenAI e la guida robots.txt di Google, che sono le fonti più affidabili per confermare il comportamento attuale dei token.
Robots.txt è ancora usato e rilevante oggi?
Robots.txt resta il metodo principale, riconosciuto dai fornitori, per esprimere le preferenze relative ai crawler, inclusi i più recenti bot AI per training e ricerca di OpenAI, Google e Anthropic. Le principali aziende AI continuano a documentare e aggiornare i token supportati, motivo per cui è ancora il primo controllo configurato dalla maggior parte dei proprietari di siti.
I bot rappresentano la maggior parte del traffico internet?
Il traffico dei bot, inclusi crawler di ricerca e agenti AI, rappresenta una quota significativa delle richieste ricevute dalla maggior parte dei siti web, anche se la proporzione esatta varia molto in base al sito e al settore. Controllare i log del proprio server per gli user agent dei crawler è il modo più affidabile per capire quanto traffico sia automatizzato, invece di basarsi su un'unica stima valida per tutto il settore.
Bloccare GPTBot blocca anche i risultati di ricerca di ChatGPT?
No, bloccare GPTBot significa solo escludere la raccolta di dati per l'addestramento e non influisce su OAI-SearchBot, che OpenAI gestisce separatamente per l'indicizzazione della ricerca. Devi bloccare OAI-SearchBot in modo specifico se vuoi anche escludere le tue pagine dai risultati di ricerca di ChatGPT.
Esplora questi argomenti