

La parità di prezzo su tutti i canali di vendita, i prezzi minimi impostati in base alle soglie e dati prodotto completi e leggibili dall'AI sono le tre mosse che più affidabilmente portano i tuoi SKU nelle raccomandazioni degli agenti AI per gli acquisti. Se le fai tutte e tre bene, entri nella valutazione. Se ne manca anche solo una, vieni escluso prima ancora che l'agente ti confronti con un concorrente.
Le tre azioni immediate:
- Garantisci la parità di prezzo nel tuo negozio Shopify o WooCommerce, nel feed Google Shopping e in tutte le inserzioni sui marketplace. L'incoerenza di prezzo tra canali può ridurre i tassi di completamento dell'acquisto di circa il 23%.
- Imposta prezzi minimi in base alle soglie così i tuoi SKU restano appena sotto i filtri di ricerca più comuni ("sotto i $50", "sotto i $100") invece di superarli di un dollaro.
- Pubblica dati prodotto completi e strutturati (JSON-LD, campi attributo completi, titoli puliti) così gli agenti possano anche solo valutare la tua scheda prodotto.
Punti chiave
Parità di prezzo, prezzi minimi impostati in base alle soglie e dati strutturati completi sono i tre fondamenti non negoziabili per far entrare i tuoi SKU nelle raccomandazioni degli agenti AI.
| Punto | Dettagli |
|---|---|
| Fai rispettare prima la parità di prezzo | L’incoerenza dei prezzi tra i canali riduce il completamento degli acquisti di circa il 23%, secondo l’analisi di Perplexity per i commercianti. |
| Imposta prezzi minimi in base alle soglie | Posizionati appena sotto i filtri di ricerca più comuni ("sotto i $50") così gli agenti includano il tuo SKU invece di escluderlo. |
| Pubblica dati strutturati completi | JSON-LD e campi attributo completi sono prerequisiti; se mancano dati, gli agenti spesso saltano del tutto la valutazione della tua scheda. |
| Testa una variabile alla volta | Esegui test randomizzati su insiemi di scelta per almeno due settimane con un gruppo holdout del 20%–30% per isolare gli effetti guidati dagli agenti. |
| Usa ecentic per il monitoraggio continuo | ecentic simula il punteggio degli agenti su ChatGPT, Gemini, Claude e Perplexity ed esegue automaticamente una nuova scansione dopo ogni modifica alla scheda prodotto. |
Cosa richiede davvero il pricing per gli agenti AI?
Questa checklist copre le leve che influenzano la selezione degli agenti. Segna ciascuna voce come completata, in corso o non avviata e procedi dall’alto verso il basso.
Vittorie rapide (da minuti a ore):
- Controllo della parità di prezzo. Recupera il prezzo live dal tuo storefront, dal feed Google Shopping e da qualsiasi marketplace attivo. Se differiscono, correggi prima il feed.
- Verifica delle soglie minime. Identifica i filtri di prezzo più comuni nella tua categoria (“sotto i $30”, “sotto i $75”, “sotto i $150”). Posizionati al livello della soglia pertinente o appena sotto, non sopra.
- Valutazione superiore a 4,0 stelle. Gli agenti attribuiscono molto peso alle valutazioni. Se la tua media è inferiore a 4,0, dai priorità alla raccolta di recensioni prima di qualsiasi altro intervento sulla scheda prodotto.
- Base minima di recensioni. Un numero ridotto di recensioni riduce la probabilità di selezione. Anche passare da 3 a 25 recensioni produce un miglioramento misurabile negli esperimenti di valutazione degli agenti esperimenti di valutazione degli agenti.
- Completezza del titolo. Includi brand, modello, specifica principale e caso d’uso principale nel titolo del prodotto. Gli agenti interpretano i titoli come segnali strutturati.
Richiede strumenti o automazione (da giorni a settimane):
- Schema JSON-LD su ogni pagina prodotto. Senza di esso, molti agenti non possono valutare la tua scheda prodotto.
- Visibilità di badge e riconoscimenti. Tag come “Overall Pick”, “Best Seller” e simili creano margine di prezzo. Rendili visibili nel feed e nel markup della pagina.
- Monitoraggio continuo della parità. I controlli manuali perdono precisione nel tempo. Configura un confronto automatico dei feed o usa una piattaforma che esegue scansioni pianificate.
- Monitoraggio dell’attribuzione agli agenti. Non puoi ottimizzare ciò che non puoi misurare. Configura il tuo store per distinguere il traffico generato dagli agenti da quello organico e a pagamento.
Suggerimento pro: Imposta il tuo prezzo minimo a $X.99 appena sotto la soglia, non sulla soglia stessa. Un agente che filtra per “sotto i $50” includerà uno SKU da $49.99 ed escluderà uno da $50.00. Una logica basata solo sul cost-plus ti farà finire dal lato sbagliato di quel filtro più spesso di quanto pensi.
Come valutano davvero i tuoi prodotti gli agenti AI?
Gli agenti non navigano come fanno le persone. Eseguono scorecard strutturate sugli attributi estratti dal feed e dal markup della pagina, poi classificano i candidati usando qualcosa di simile a un modello di utilità ponderata. La ricerca della Columbia Business School conferma che modelli di agenti diversi attribuiscono pesi differenti agli stessi attributi, il che significa che ottimizzare per un solo agente ignorando gli altri è un rischio reale.
Il prezzo è un peso negativo in tutti i modelli testati. Valutazioni e numero di recensioni sono pesi positivi. La posizione nei risultati e i tag di riconoscimento aggiungono utilità che può compensare un prezzo più alto.
Dato chiave: Gli esperimenti randomizzati ACES riportano stime di elasticità del prezzo comprese approssimativamente tra −1.6 a −2.8 nei vari modelli di agenti e gruppi di prodotti. Un aumento di prezzo del 10% riduce la probabilità di selezione del 16%–28% a seconda del modello, a parità di altre condizioni.
| Attributo | Effetto direzionale sulla selezione | Fonte delle evidenze |
|---|---|---|
| Prezzo | Negativo (forte) | Esperimenti ACES / arXiv |
| Valutazione a stelle | Positivo (forte) | Esperimenti ACES / arXiv |
| Numero di recensioni | Positivo (moderato) | Esperimenti ACES / arXiv |
| Posizione della scheda prodotto | Positivo (dipendente dal modello, elevato) | Columbia Business School |
| Tag di endorsement (“Overall Pick”) | Positivo (molto elevato, dipendente dal modello) | Esperimenti ACES / arXiv |
| Completezza dei dati strutturati | Condizione necessaria (richiesta per essere valutato) | Sintesi pratica di AgentMint |
Una cosa che emerge chiaramente dalla ricerca della Columbia: gli agenti selezionano in base alla completezza dei dati prima ancora di considerare il prezzo. Una scheda prodotto con attributi mancanti non riceve un punteggio inferiore. Spesso non viene valutata affatto.
Il playbook del pricing: sette tattiche classificate per impatto
Parti dalla parità. Tutto il resto è secondario finché i tuoi prezzi non coincidono su tutti i canali.
Tattiche prioritarie:
- Applica prima la parità di prezzo tra canali. Un’analisi di Perplexity sui merchant ha rilevato che l’incoerenza dei prezzi tra storefront DTC, Google Shopping e schede prodotto sui marketplace riduce il completamento degli acquisti di circa il 23%. Risolvi questo problema prima di qualsiasi altro intervento sul pricing.
- Imposta prezzi minimi consapevoli delle soglie. Mappa i filtri di ricerca più comuni nella tua categoria e posizionati appena sotto ciascuno di essi. Non si tratta di fare sconti. Si tratta di restare all’interno del filtro.
- Usa i tag di endorsement per aumentare il margine di prezzo. Gli esperimenti ACES mostrano che i tag in stile “Overall Pick” generano un margine di prezzo stimato molto elevato, sufficiente in alcuni modelli a compensare un sovrapprezzo significativo rispetto ai concorrenti senza tag. Mostra ogni badge ottenuto nel markup del feed.
- Usa i bundle come ancoraggio. Un bundle a $89 accanto a un prodotto singolo a $59 fa apparire il prodotto singolo come un affare a un agente che interpreta il valore relativo. Gli agenti leggono i segnali di ancoraggio nei dati strutturati.
- Esegui promozioni a tempo limitato legate alle finestre di query degli agenti. Gli agenti interrogati durante i periodi di picco degli acquisti attribuiscono peso alla recente modifica dei prezzi. Uno sconto temporaneo attivo quando l’agente esegue la scansione supera un prezzo permanente impostato sei mesi prima.
- Riposizionati in modo permanente solo quando l’elasticità lo supporta. Usa l’intervallo di elasticità da −1.6 a −2.8 come input di pianificazione. Se un taglio di prezzo del 10% produce un aumento della selezione inferiore al 16% nella tua categoria, il sacrificio di margine non vale la pena.
- Applica il repricing automatico con limiti di sicurezza. Repricing autonomo può reagire più rapidamente delle regole manuali, ma richiede dati puliti su concorrenti e inventario. Imposta soglie minime di margine rigide prima di attivare qualsiasi repricing automatico.
Si tratta di un margine reale, anche se l’intervallo è ampio e dipende dal modello.
Come testare le variazioni di prezzo contro gli agenti AI
Esegui test randomizzati su insiemi di scelta. Presenta agli agenti set di prodotti speculari in cui cambia solo la variabile testata (prezzo, badge, descrizione), poi misura tasso di selezione, tasso di conversione e ordini attribuiti all’AI.
Struttura del test numerata:
- Definisci una variabile per test. Prezzo, tag di riconoscimento o riscrittura della descrizione. Non modificarne mai due contemporaneamente.
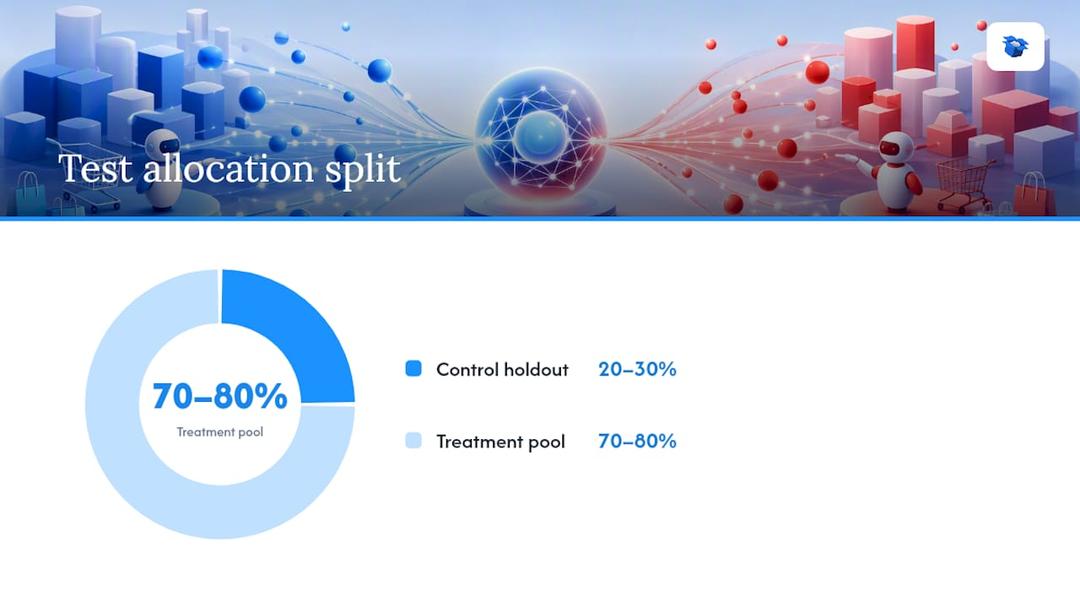
- Crea un gruppo holdout. Mantieni il 20%–30% degli SKU al prezzo di controllo così da avere un riferimento pulito.
- Esegui il test per almeno due settimane complete. Finestre più brevi sono troppo esposte alle variazioni giornaliere e al rumore promozionale.
- Randomizza a livello di SKU, non a livello di categoria, per evitare distorsioni dovute alla posizione.
- Configura l’attribuzione agli agenti prima di iniziare. Senza monitoraggio del traffico degli agenti, stai misurando la conversione totale, non quella guidata dagli agenti.
| Metrica | Definizione | Come misurare |
|---|---|---|
| Tasso di selezione da parte degli agenti | % di query degli agenti in cui viene scelto il tuo SKU | Tag dei campi UCP/profilo + log di attribuzione degli agenti |
| Tasso di conversione degli agenti | Ordini da sessioni riferite dagli agenti / sessioni degli agenti | Parametri UTM + fonte di referral dell’agente |
| Ricavi attribuiti all’AI | Ricavi da ordini confermati guidati dagli agenti | Dashboard di attribuzione con filtro per fonte agente |
| Delta del margine di prezzo | Variazione del tasso di selezione per % di variazione del prezzo | Modello logit condizionale sui dati del gruppo di test |
Errori comuni: i cambiamenti di posizione durante un test contaminano i risultati sul prezzo. Le promozioni stagionali attive in parallelo gonfiano la conversione per entrambi i gruppi. Evita di lanciare test durante grandi eventi di vendita.
Checklist di implementazione per Shopify e WooCommerce
Pubblica schemi prodotto leggibili dall’AI, applica la parità dei feed e abilita scansioni continue. Questa è la versione breve. Ecco come eseguirla.
Giorno 1:
- Installa o verifica un plugin per lo schema JSON-LD. Su Shopify, app come Schema Plus o TinySEO gestiscono questa funzione. Su WooCommerce, Yoast SEO o Rank Math generano automaticamente lo schema prodotto se configurati correttamente. Segui la checklist dei dati strutturati per verificare ogni campo richiesto.
- Controlla il tuo feed prodotto per individuare attributi mancanti: GTIN, brand, condizione, disponibilità e prezzo. Gli agenti usano questi campi come criteri obbligatori per la valutazione.
- Configura un monitor della parità di prezzo. Esporta i prezzi correnti da Shopify o WooCommerce e confrontali con il feed Google Shopping e qualsiasi feed marketplace attivo.
Settimana 1:
- Compila i campi UCP (Universal Commerce Profile) se la tua piattaforma li supporta. Questi campi permettono agli agenti di leggere un contesto prodotto strutturato oltre lo schema standard.
- Aggiungi markup per badge e riconoscimenti alle pagine prodotto. Se hai ottenuto una designazione come “Best Seller” o “Overall Pick”, deve comparire nei tuoi dati strutturati, non solo visivamente nella pagina.
- Collega il tuo store a un sistema di attribuzione degli agenti. Per WooCommerce, l’integrazione WooCommerce di ecentic gestisce la connessione del feed e la pianificazione delle scansioni.
Mese 1:
- Abilita il monitoraggio automatico della parità con avvisi per deviazioni di prezzo oltre una soglia impostata (1%–2% è un trigger ragionevole).
- Pianifica scansioni continue in modo che i punteggi delle schede prodotto vengano aggiornati dopo ogni modifica di prezzo o descrizione.
- Controlla la diagnostica AI delle schede prodotto per identificare quali attributi stanno abbassando la tua scorecard.
Cosa si rompe quando i modelli degli agenti vengono aggiornati?
Gli aggiornamenti dei modelli cambiano il peso attribuito agli attributi. Un bias di posizione che favoriva le schede prodotto in prima posizione in una versione del modello può attenuarsi o invertirsi nella successiva. I merchant che hanno ottimizzato in modo aggressivo per il peso di un solo modello senza monitorare gli altri sono quelli che perdono visibilità da un giorno all’altro.
Principali rischi da monitorare:
- Cambiamenti nel bias di posizione. La ricerca della Columbia Business School documenta effetti di posizione elevati e dipendenti dal modello. Quando un modello viene aggiornato, il valore della tua posizione può cambiare senza alcuna azione da parte tua.
- Errori di parità che attivano la soppressione. Se il tuo prezzo esce dalla parità dopo la fine di un periodo promozionale, gli agenti possono declassare o escludere la tua scheda prodotto.
- Falsi negativi dovuti a piccole differenze di prezzo. Una discrepanza di $0.50 tra il tuo storefront e il feed può bastare per attivare un flag di parità in alcuni modelli di agenti.
- Descrizioni non aggiornate. Gli agenti eseguono scansioni periodiche. Una descrizione ottimizzata sei mesi fa può ricevere un punteggio diverso dopo un aggiornamento del modello che cambia il modo in cui vengono interpretati i segnali testuali.
Checklist degli avvisi:
- Ogni settimana: controlla la parità di prezzo su tutti i canali attivi.
- Ogni due settimane: esegui una query simulata degli agenti per i tuoi 10 SKU principali e confronta i tassi di selezione con il periodo precedente.
- Ogni mese: controlla i dati di attribuzione degli agenti per individuare cali inspiegabili nelle sessioni riferite dagli agenti.
- Dopo qualsiasi annuncio di aggiornamento del modello: riesegui l’intera suite di simulazioni prima di dare per stabili i tuoi punteggi.
Quando un aggiornamento del modello cambia il panorama competitivo, hai bisogno di margine per riprezzare senza andare in negativo. I merchant che impostano soglie minime troppo strette si ritrovano impossibilitati a reagire senza un override manuale.*
Che tipo di risultati dovresti aspettarti?
Risultati realistici, non garantiti. È questa la premessa corretta.
Gli esperimenti ACES mostrano che la riscrittura di descrizioni e titoli produce aumenti a doppia cifra della quota di selezione in specifiche coppie categoria-modello, con alcune modifiche che spostano la quota di oltre 30 punti percentuali. Ma molte modifiche non producono alcun effetto misurabile. I risultati sono eterogenei: ciò che funziona nell’elettronica di consumo può non fare nulla nell’abbigliamento.
Intervallo di riferimento: Le stime dell’elasticità al prezzo dagli esperimenti ACES vanno da −1.6 a −2.8. Per un commerciante che vende a $45 in una categoria in cui l’elasticità è −2.0, una riduzione di prezzo di $5 (11%) dovrebbe aumentare la probabilità di selezione di circa il 22%, a parità di condizioni.
Cosa supportano davvero le evidenze:
- L’applicazione della parità di prezzo produce aumenti costanti e misurabili nel completamento dell’acquisto. Il dato del 23% di penalizzazione dall’analisi merchant di Perplexity è il numero singolo più chiaro nella letteratura pratica.
- I tag di endorsement creano margine di prezzo, anche in misura rilevante, ma l’entità varia in base al modello e alla categoria.
- La completezza dei dati strutturati è un requisito di accesso, non un elemento differenziante. Ti serve per competere, ma averla non garantisce la selezione.
- Molte ottimizzazioni singole non mostrano alcun effetto se valutate isolatamente. Questo playbook funziona come sistema, non come insieme di leve indipendenti.
I risultati variano in base alla categoria, al modello di agente e alla densità competitiva. Esegui i tuoi test invece di presumere che le medie sperimentali si applichino ai tuoi SKU specifici.
Una nota su come affrontiamo questo tema in ecentic
I commercianti che ottengono di più da questa guida operativa sono quelli che considerano l’ottimizzazione per gli agenti un processo continuo, non un intervento una tantum. In ecentic, il motore di simulazione esegue test di confronto tra prodotti contemporaneamente su ChatGPT, Gemini, Claude e Perplexity, così vedi quali schede prodotto vengono scelte e quali scartate prima che lo faccia un agente in risposta a una richiesta reale. Le scansioni continue fanno sì che una modifica al prezzo o alla descrizione attivi automaticamente una nuova diagnosi. La combinazione di simulazione, monitoraggio della coerenza dei dati e scansioni automatiche riduce il rischio che un aggiornamento del modello cancelli mesi di lavoro di ottimizzazione. È questo il ciclo che la guida qui sopra aiuta a completare.
ecentic ti offre il livello di simulazione di cui questo playbook ha bisogno
La maggior parte dei merchant esegue questo playbook manualmente: esporta i feed, controlla la parità, riscrive le descrizioni, spera che la prossima sessioni di esempio degli agenti vada meglio. ecentic sostituisce queste ipotesi con un sistema. Collega il tuo store Shopify o WooCommerce, ed ecentic simula come ChatGPT, Gemini, Claude e Perplexity valutano le tue schede prodotto in questo momento, poi fornisce diagnosi in linguaggio chiaro su cosa sta penalizzando il tuo punteggio.

Il monitoraggio della parità è continuo. Le riscritture di descrizioni e titoli vengono suggerite e possono essere pubblicate in un clic. L’attribuzione agli agenti ti mostra quali SKU vengono effettivamente consigliati e acquistati tramite sessioni con agenti. Per i commercianti che hanno letto questo playbook e vogliono l’infrastruttura di misurazione necessaria per applicarlo correttamente, la scansione gratuita dei prodotti è il modo più rapido per capire qual è la situazione oggi.
FAQ
Come decidono gli agenti AI quali prodotti consigliare?
Gli agenti valutano le schede prodotto usando attributi strutturati: prezzo, valutazione in stelle, numero di recensioni, posizione della scheda e tag di endorsement. La completezza del feed di prodotto è un requisito di accesso; i campi mancanti spesso fanno sì che la tua scheda non venga affatto valutata.
Qual è il più grande errore di prezzo che penalizza le raccomandazioni degli agenti AI?
L’incoerenza di prezzo tra i canali. Correggi la parità prima di qualsiasi altra ottimizzazione del prezzo.
Quanto incide il prezzo sulla probabilità di selezione da parte degli agenti AI?
Gli esperimenti randomizzati ACES riportano stime di elasticità al prezzo comprese tra −1.6 e −2.8 nei diversi modelli di agente.
Tag di endorsement come “Overall Pick” possono compensare un prezzo più alto?
Sì, in alcuni modelli anche in modo significativo. Gli esperimenti ACES mostrano che i tag di endorsement creano un margine di prezzo misurabile: significa che un prodotto con tag può avere un prezzo più alto di un concorrente senza tag e risultare comunque selezionato. L’entità dell’effetto dipende dal modello.
In che modo ecentic aiuta i commercianti a ottimizzare per gli agenti AI per gli acquisti?
Ecentic simula come ChatGPT, Gemini, Claude e Perplexity valutano le tue schede prodotto, fornisce diagnosi in linguaggio semplice e ripete automaticamente la scansione dopo modifiche ai prezzi o alle descrizioni. Inoltre monitora la coerenza dei prezzi tra i canali e supporta aggiornamenti delle schede prodotto con un clic per i negozi Shopify e WooCommerce.
Esplora questi argomenti