

Che le persone cerchino con Google, vadano su Amazon o chiedano a un chatbot, l'AI restituisce una risposta con un prodotto, e la maggior parte dei brand e-commerce non ha idea di come diventare quel prodotto. L'attribuzione AI omnicanale usa il machine learning per capire come ogni canale, online e offline, abbia contribuito a un ordine. Richiede dati puliti sui touchpoint, alcuni mesi di storico e un modo per verificare che le sue risposte siano causali, non solo plausibili.
Ecco la mia lettura: l'attribuzione è sempre stata una storia che i dati raccontano sul passato, e l'AI rende soprattutto quella storia più scorrevole. È utile, a patto di ricordare chi l'ha scritta. Nel frattempo è comparso un nuovo canale, in cui l'assistente agli acquisti del cliente legge il tuo feed di prodotto, sceglie un prodotto e a volte lo acquista. La maggior parte delle dashboard di attribuzione non ha una colonna per questo.
In breve
- L'attribuzione omnicanale unisce ogni touchpoint, inclusi i canali offline e proprietari, in un unico quadro. L'attribuzione multicanale di solito confronta i canali digitali uno alla volta.
- I modelli AI richiedono dati sui touchpoint e sulle conversioni a livello utente. Adobe dice che un buon modello richiede almeno 90 giorni di dati e 1.000 conversioni.
- L'attribuzione descrive ciò che è successo. Solo gli esperimenti ti dicono cosa ha causato il tuo marketing, quindi calibra il modello con gli holdout.
- Introducila per fasi: definisci i KPI, verifica i dati, centralizzali, testa i modelli, poi modifica la spesa e osserva il risultato.
- Gli assistenti AI sono ormai una fonte di visite e ordini. Etichettali come un canale a sé e correggi i dati prodotto che leggono.
Cosa significa in pratica l'attribuzione omnicanale
L'attribuzione multicanale assegna il merito tra i canali digitali che utilizzi: ricerca a pagamento, social, email, affiliazioni. Ognuno riceve una quota dell'ordine. L'attribuzione omnicanale prova ad andare oltre. Considera il cliente come un'unica persona che vede uno spot sulla connected TV, visita un negozio, apre un'email e poi acquista sul sito, e si chiede come questi canali si rafforzino a vicenda.
La definizione cambia leggermente da un fornitore all'altro, e questo conta, perché le regole sui dati del fornitore determinano cosa copre davvero “omnicanale”. Prendiamo Klaviyo. La sua documentazione del centro assistenza sull'attribuzione omnicanale descrive la combinazione delle sessioni sul sito identificate con le interazioni ai messaggi Klaviyo. Può includere attività anonime dopo che il cliente viene identificato in un secondo momento, se quell'impostazione è attiva. Le sessioni provenienti da altre fonti vengono conteggiate solo se includono parametri di attribuzione e rientrano nella finestra configurata. È un'impostazione perfettamente sensata per una piattaforma email e SMS. È anche un'idea di “omnicanale” più limitata rispetto a quella che userebbe chi pianifica campagne TV.
Il test pratico è questo: quando uno strumento parla di omnicanale, chiedi quali touchpoint può vedere davvero e quali invece deduce. Un negozio con un POS, una presenza sui marketplace e un sito Shopify ha tre fonti dati che raramente concordano su chi sia il cliente. Il livello di attribuzione è integrato solo quanto lo è il livello di identità sottostante.
Cosa aggiunge la parte AI
Le regole classiche sono semplici. Il first touch assegna il merito alla prima interazione, il last touch all'ultima, il modello lineare lo divide in modo uniforme. I modelli basati sull'AI imparano invece i pesi dai dati.
La documentazione di Adobe è un buon esempio concreto. La sua panoramica di Attribution AI dice che il servizio calcola l'influenza e l'impatto incrementale delle interazioni cliente lungo canali e fasi del percorso, incluse impression display, invii e aperture email e clic sulla ricerca a pagamento. La stessa pagina elenca anche i punteggi basati su regole supportati: first-touch, last-touch, lineare, a U e time-decay. Quindi anche il prodotto AI mantiene i vecchi modelli per il confronto, ed è una scelta sensata.
Il secondo elemento è la copertura offline. La documentazione sul unified modeling di Adobe descrive un modello AI causale che combina marketing-mix modeling aggregato e attribuzione multi-touch a livello di evento. La parte a livello di evento spiega il percorso. La parte aggregata cattura i canali offline, i rendimenti decrescenti e il modo in cui i canali interagiscono. Nessuno dei due basta da solo, ed è il motivo principale per cui esistono gli approcci ibridi.
Quindi cosa offre davvero l'AI? Tre cose, leggendo questi sistemi:
Gestisce molti touchpoint senza dover scegliere manualmente i pesi. Può modellare effetti ritardati, cosa importante per acquisti ponderati. E ricalcola le stime quando il comportamento cambia. Quello che non offre è la verità. Offre una stima meglio adattata.
I dati necessari
È qui che la maggior parte dei progetti si blocca, di solito prima ancora di costruire un modello.
La documentazione input e output di Attribution AI di Adobe è specifica. Il modello richiede campi di identità e timestamp per touchpoint e conversioni, campi di canale e marketing per i touchpoint e dati di conversione ecommerce. Un buon modello richiede almeno 90 giorni di dati e almeno 1.000 conversioni, e le impostazioni predefinite di training e lookback richiedono 236 giorni di input. Adobe consiglia inoltre di includere quante più colonne possibili relative a conversioni e touchpoint.
Ora confrontalo con un piccolo negozio. Se fai 200 ordini al mese, non raggiungerai 1.000 conversioni entro il minimo di 90 giorni. Non è un giudizio sul tuo marketing, ma solo su quel prodotto specifico. I team più piccoli ottengono risultati migliori con modelli semplici e trasparenti più alcuni test holdout ben eseguiti.
I dati possono provenire dagli analytics del fornitore stesso o da fonti esterne, come dice la stessa panoramica Adobe . Gli approcci neurali basati su grafi richiedono ancora più dati. La documentazione tecnica sull'attribuzione delle conversioni di Kumo dice che richiedono dati del percorso utente a livello individuale, timestamp ed eventi di conversione chiari, e che non sono adatti quando hai solo dati aggregati per canale.
In pratica, prima che qualsiasi modello sia utile servono tre cose:
| Cosa hai | Cosa si adatta |
|---|---|
| Spesa e vendite aggregate per settimana, senza percorsi utente individuali | Marketing-mix modeling e semplici test holdout |
| Dati web ed email a livello utente, un'unica identità | Attribuzione multi-touch basata su regole e guidata dai dati |
| Dati a livello utente tra web, app, negozio e pubblicità, più volume | Attribuzione con machine learning calibrata con esperimenti |
Questa tabella riflette i requisiti dati nella documentazione Adobe e Kumo sopra. Scegli la riga in cui ti trovi, non quella in cui vorresti essere.
L'attribuzione non è la misurazione incrementale
Se devi leggere una sola cosa prima di acquistare uno strumento di attribuzione, leggi la differenza tra queste due idee.
Le linee guida IAB per la misurazione incrementale nei commerce media, pubblicate a novembre 2025, le separano chiaramente. Attribuzione e ROAS descrivono il contributo osservato, cioè cosa è successo. La misurazione incrementale stima invece il risultato aggiuntivo causato dal marketing, rispetto a un controfattuale credibile senza marketing. Le linee guida elencano i metodi che permettono di ottenerlo: gruppi di controllo randomizzati, holdout o ghost ads, mercati abbinati e controlli sintetici. Avvertono anche che stagionalità, prezzi, promozioni, concorrenti, campagne simultanee, bias di selezione, multicollinearità e collegamenti incompleti dell'esposizione possono distorcere la stima.
È per questo che i numeri del Black Friday sono difficili da leggere. Tutto si muove contemporaneamente.
I ricercatori stanno cercando di colmare il divario. Uno studio pubblicato su Management Science, Predicted Incrementality by Experimentation, pubblicato l'8 ottobre 2026, ha utilizzato 2.226 esperimenti Meta per apprendere una mappatura dagli esperimenti alle campagne non sperimentali. Riporta un R² out-of-sample di 0,88 per conversioni incrementali per dollaro, contro 0,19 per l'attribuzione last-click a sette giorni. Riporta anche che il metodo era in disaccordo con le decisioni basate sugli esperimenti nell'8%-12% delle campagne, contro il 12%-20% del last-click.
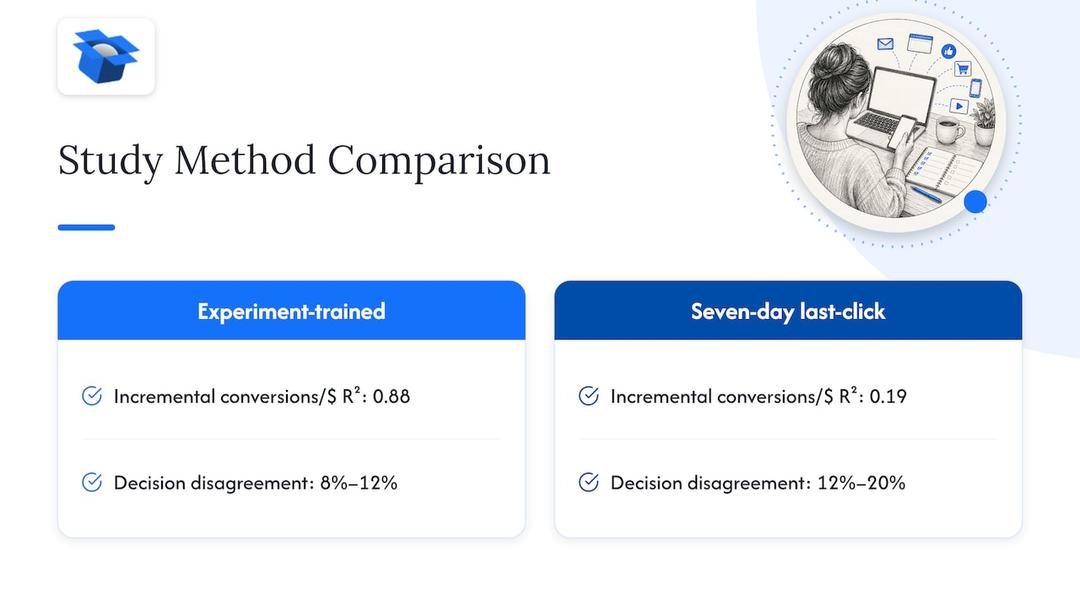
Da questo traggo due conclusioni. Il last-click è un predittore debole di ciò che la pubblicità causa davvero, come molti sospettavano. E l'approccio con le migliori prestazioni ha comunque imparato da esperimenti randomizzati. L'AI non ha sostituito l'esperimento, lo ha esteso.
Una precisazione importante: quello studio riguarda campagne pubblicitarie su una sola piattaforma. Non dice come si comportano email, traffico in negozio o canali organici nel tuo caso. Consideralo una prova del metodo, non un benchmark per i tuoi numeri.
Un rollout che puoi eseguire questo trimestre
Il playbook IAB per la misurazione cross-channel presenta una sequenza che funziona per team ecommerce di quasi tutte le dimensioni. Eccola in ordine operativo:
- Definisci l'obiettivo e i KPI. Scegli la decisione che il modello deve cambiare, per esempio spostare budget tra paid social ed email. Se nessuna decisione dipende dalla risposta, evita il progetto.
- Mappa canali e touchpoint. La guida all'attribuzione di Dataiku consiglia di elencare ogni touchpoint e documentarne fonte dati e limiti, perché dati poco compresi riducono sia l'accuratezza sia la fiducia degli stakeholder.
- Centralizza i dati. Il playbook IAB descrive il consolidamento di ogni canale in un data warehouse o data lake, l'applicazione della governance e l'automazione dell'ETL (i processi che spostano e puliscono i dati) dove possibile.
- Testa più modelli in parallelo. Lo stesso playbook raccomanda l'attribuzione guidata dai dati con machine learning insieme a modelli single-touch e multi-touch basati su regole. Quando non concordano, è già un'informazione.
- Imposta il lookback in modo realistico. Adobe Mix Modeler permette ai team di definire finestre di lookback da 1 a 52 settimane e configurare adstock e lag specifici per canale, così i canali lenti non vengono trattati come istantanei.
- Controlla privacy e consenso. Fallo prima dello sviluppo, non dopo il lancio.
- Modifica la spesa, poi osserva. Dataiku spiega che i modelli di attribuzione non possono essere valutati come normali predittori, perché non esiste un'etichetta nota con cui confrontarli. Il test pratico è spostare il budget in base al modello e osservare i risultati di business.
Il settimo passaggio è quello che i team saltano. Un modello su cui nessuno agisce è una dashboard.
Limiti e privacy, spiegati chiaramente
La guida alle best practice IAB per la misurazione cross-channel indica come ostacoli i silos di dati, la complessità dell'attribuzione, le barriere tecnologiche e i problemi di privacy. Le soluzioni raccomandate sono dati centralizzati, registri granulari a livello impression, modelli di attribuzione adatti alla domanda, analytics predittivi, dashboard e gestione del consenso. Nulla in questo elenco è esotico. Si tratta soprattutto di organizzazione, ed è proprio questa a determinare se un modello funziona.
Il report State of Data 2026 dell'IAB, uno studio statunitense di febbraio 2026, afferma che le normative sulla privacy e i cambiamenti delle piattaforme hanno frammentato i dati tra sistemi scollegati. Elenca problemi legali, di sicurezza, accuratezza, qualità dei dati, accessibilità, configurazione, costi e bias come principali ostacoli all'adozione dell'AI nella misurazione.
Le tecniche che preservano la privacy hanno un costo. Una revisione sistematica del 2026 di 108 studi riporta che la privacy differenziale ha ridotto la precisione dal 2% al 33%, a seconda del budget di privacy nelle impostazioni documentate. La stessa revisione afferma che gli approcci federati hanno mantenuto circa il 90%-95% delle prestazioni centralizzate nelle implementazioni documentate, mentre generalizzazione e credibilità causale restano poco testate. Rileva inoltre che l'attribuzione basata su deep learning può migliorare l'accuratezza predittiva, ma rimane causalmente non identificata senza calibrazione sperimentale.
Quindi la sintesi più onesta è questa: più privacy di solito significa un modello meno preciso, e un modello più preciso non è automaticamente più corretto. Entrambi sono motivi per mantenere un esperimento nel processo.
Il canale che la maggior parte delle configurazioni di attribuzione ignora
È qui che inizio a non essere d'accordo con il playbook standard. Presuppone che sia il cliente a cliccare. Una quota crescente della scoperta prodotto passa invece attraverso un assistente che legge i tuoi dati per conto del cliente. L'assistente non vede mai la homepage. Legge il feed prodotti, il catalogo e i dati strutturati delle schede prodotto (le etichette leggibili dalle macchine che indicano cos'è un prodotto, quanto costa e come viene spedito).
Su AI Mode di Google e Gemini negli Stati Uniti, un agente può persino completare l'acquisto per il cliente tramite UCP, lo standard aperto di Google per il checkout degli agenti. ChatGPT, invece, rimanda alla procedura d'acquisto del negozio. OpenAI ha ACP, Google ha UCP, Amazon ha un ecosistema chiuso.
Per l'attribuzione questo crea due problemi. Primo, le visite provenienti dagli assistenti finiscono spesso nelle categorie “direct” o “referral”, quindi il canale diventa invisibile. Secondo, la scelta dell'assistente avviene prima di qualsiasi touchpoint misurabile. Se i tuoi dati prodotto perdono il confronto, non ottieni nemmeno la visita da attribuire.
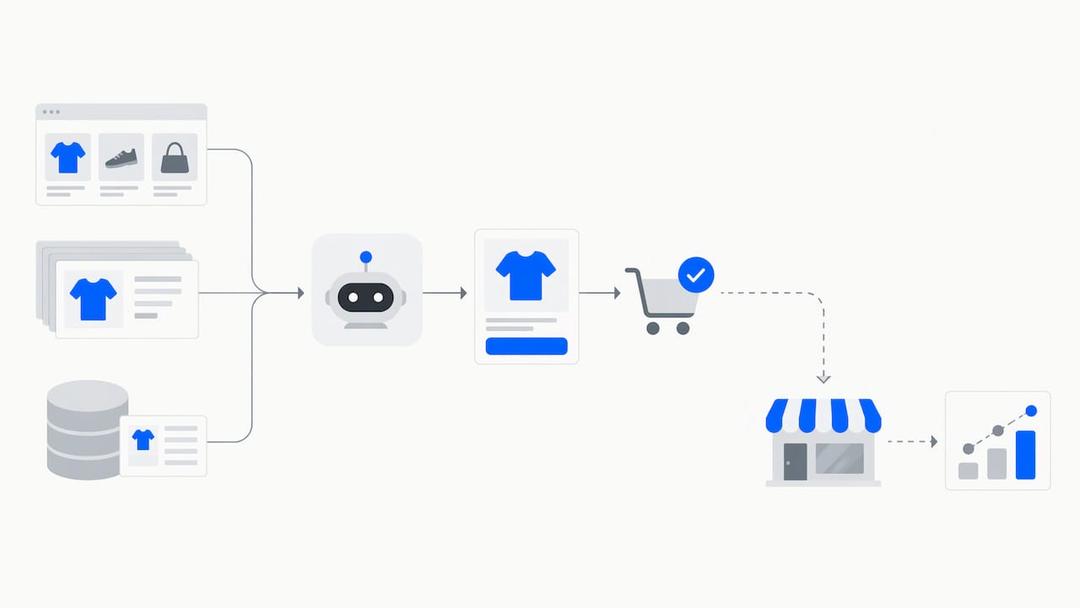
Abbiamo visto quanto sia sbilanciata questa scelta. Nelle nostre simulazioni di acquisto sullo stesso catalogo, ChatGPT ha scelto il prodotto circa tre volte più spesso di Claude o Gemini, 51,6% contro circa 18,5%. In pratica ogni assistente è un canale separato con regole proprie. Se vuoi approfondire la parte di misurazione, queste pagine la trattano: come tracciare il traffico degli assistenti AI per gli acquisti, cosa puoi misurare con l'attribuzione AI per l'ecommerce e attribuzione cookieless con AI. Se stai scegliendo un software, il nostro confronto tra strumenti di attribuzione AI indica le alternative e per chi sono più adatte.
Una precisazione importante: ecentic non è una suite completa di attribuzione omnicanale. Non modellerà la tua spesa TV o il traffico fisico in negozio. Su Shopify traccia le visite provenienti dagli assistenti AI, colmando il vuoto descritto sopra, e non traccia ricavi o vendite. Per il resto continua a usare il tuo stack principale di attribuzione.
La nostra visione su dove sta andando l'attribuzione
Pensiamo che la prossima sfida dell'attribuzione non riguardi i cookie. Riguardi chi viene scelto prima del clic. Quando un agente AI risponde a un cliente con un solo prodotto, i brand che perdono quel confronto non compaiono in nessun report, per quanto sofisticato sia il modello.
Per questo lavoriamo sul negozio stesso: feed prodotti, catalogo e checkout usato dagli agenti per acquistare. ecentic si collega a Shopify, WooCommerce o a un feed prodotti, fa confrontare ogni prodotto da ChatGPT, Claude e Gemini con quello di un concorrente specifico e mostra perché perde. Quando il merchant clicca Applica, ecentic riscrive titolo, descrizione e dati strutturati e li pubblica nel negozio.
Su Shopify, ecentic invia le correzioni a Google Merchant Center e traccia le visite dagli assistenti AI. Su WooCommerce, il plugin gratuito ecentic permette agli agenti di cercare, riempire un carrello e completare l'acquisto tramite UCP. È proprio questa parte di checkout che i normali strumenti per feed non gestiscono.
I numeri sono ancora iniziali e lo diciamo chiaramente. Nel nostro primo pilota, DUA Flavours, le visite dagli assistenti AI e il traffico diretto sono aumentati del 12% da aprile a luglio 2026. È un dato sulle visite, non sulle vendite, e non lo presentiamo come altro.
L'ordine sensato, secondo me, è questo: continua a misurare i canali classici, calibra con esperimenti e assicurati prima di tutto che gli agenti possano leggere e acquistare dal tuo negozio. Misurare un canale che stai perdendo è un modo molto accurato per osservare la tua sconfitta.
Xhurian Shaba
Provalo sui tuoi prodotti
Se vuoi vedere come gli assistenti confrontano i tuoi prodotti con quelli di un concorrente specifico, inizia con la scansione gratuita. Copre i tuoi 10 prodotti principali e non richiede carta. Mostra in inglese semplice perché un agente sceglie l'altro prodotto, così sai cosa cambiare in titolo, descrizione e dati strutturati.

I piani a pagamento partono da Compete a $14.90 al mese per un massimo di 100 prodotti. Scale costa $44.90 al mese per fino a 1.000 prodotti con correzioni in un clic. Dominate costa $149 al mese e aggiunge la sincronizzazione con Google Merchant Center e la configurazione del checkout per agenti. È disponibile anche un'opzione pay-as-you-go pari al 3% degli ordini attribuiti all'AI, con un tetto massimo di $500 al mese. I termini aggiornati sono nella pagina prezzi di ecentic, e come funziona spiega simulazione, diagnosi e ottimizzazione.
FAQ
Qual è la differenza tra attribuzione omnicanale e multicanale?
L'attribuzione multicanale divide il merito tra i canali digitali che utilizzi, di solito canale per canale. L'attribuzione omnicanale cerca invece di collegare tutti i touchpoint, inclusi quelli offline e proprietari, attorno a un unico cliente. In pratica la differenza dipende dai dati che lo strumento riesce davvero a unire, quindi controlla quali touchpoint vede.
Quanti dati servono per l'attribuzione AI?
Dipende dal prodotto. La documentazione di Adobe Attribution AI dice che un buon modello richiede almeno 90 giorni di dati e 1.000 conversioni, e che le impostazioni predefinite richiedono 236 giorni di input. I negozi sotto quel volume ottengono in genere risultati migliori con modelli più semplici e test holdout.
L'attribuzione AI può dimostrare quale canale ha causato una vendita?
No, non da sola. Le linee guida IAB affermano che l'attribuzione descrive ciò che è successo, mentre l'incrementality richiede un controfattuale credibile come un holdout o mercati abbinati. Usa il modello per formulare ipotesi e l'esperimento per confermarle.
L'attribuzione omnicanale copre il traffico proveniente dagli assistenti AI?
Solo se la configuri in questo modo. Molte configurazioni raggruppano le visite degli assistenti nel traffico direct o referral. Etichetta gli assistenti come fonte separata e assicurati che i dati prodotto che leggono siano completi, così potranno scegliere i tuoi prodotti fin dall'inizio.
Fonti
- Capire l'attribuzione omnicanale, Centro assistenza Klaviyo
- Panoramica di Attribution AI, Adobe Experience Platform
- Unified Modeling, Adobe Marketing Campaign Analytics
- Input e output in Attribution AI, Adobe Experience Platform
- Attribuzione delle conversioni per Ad Tech, Kumo
- Linee guida per la misurazione incrementale nei commerce media, IAB
- Predicted Incrementality by Experimentation, Management Science
- Implementare la misurazione cross-channel per i marketer, IAB
- Potenziare l'attribuzione marketing con il machine learning, Dataiku
- Creare modelli in Mix Modeler, Adobe
- Best practice di misurazione cross-channel per marketer, IAB
- IAB State of Data 2026
- AI affidabile per la misurazione marketing: una revisione sistematica, SSRN
Esplora questi argomenti