

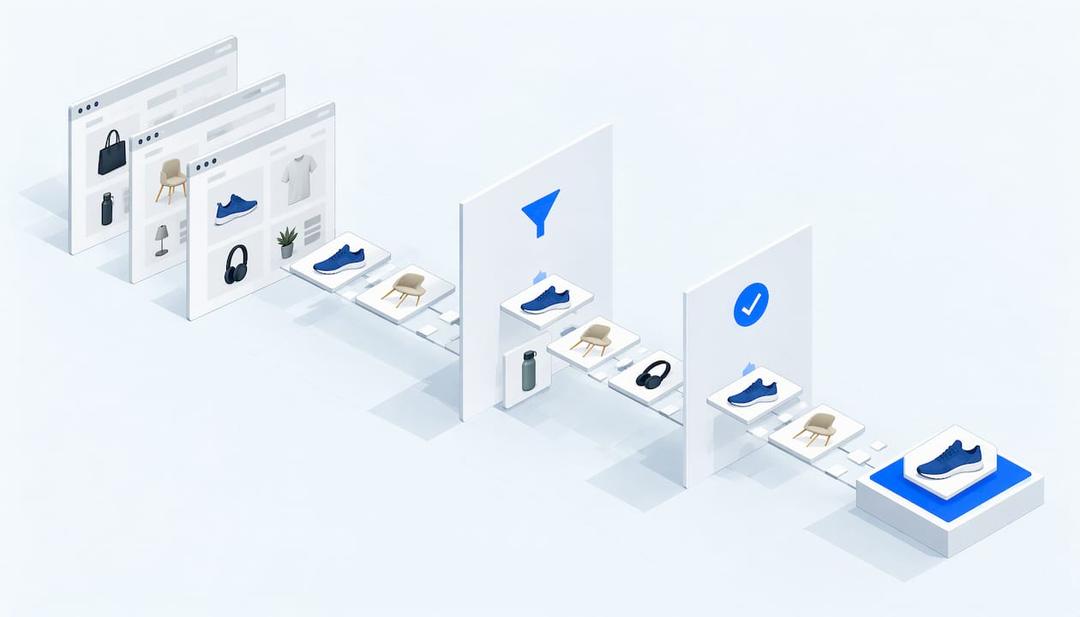
La valutazione degli LLM nell'ecommerce significa testare se un modello linguistico completa correttamente attività di acquisto reali: trovare il prodotto giusto, confrontarlo con altri e aggiungerlo al carrello. Per un negozio, questo ha due versioni. Puoi testare un chatbot che gestisci sul tuo sito oppure testare come gli agenti AI esterni trattano i tuoi prodotti. Che le persone cerchino su Google, vadano su Amazon o chiedano a un chatbot, oggi l'AI risponde con un prodotto e la maggior parte dei brand e-commerce non ha idea di come fare per essere quel prodotto.
La mia opinione: quasi tutto ciò che si dice sulla valutazione è rivolto a chi costruisce il modello, e quasi per niente a chi deve vendere attraverso di esso. Se gestisci un negozio, non ti serve dare un voto al modello. Ti serve sapere perché sceglie il prodotto di qualcun altro, che è un esame diverso, e a sostenerlo è il negozio.
In breve
- Valutare un agente per gli acquisti significa misurare l'intero processo (ricerca, chiarimento, raccomandazione, aggiunta al carrello), non singole risposte.
- Le ricerche attuali mostrano che anche i modelli più forti falliscono molte attività di acquisto, quindi i tuoi dati di prodotto devono compensare più di quanto spereresti.
- Gli agenti leggono il tuo feed di prodotto, il catalogo e i dati strutturati, non la homepage. Identificatori mancanti, prezzi vaghi e specifiche non quantificate portano all'esclusione del tuo prodotto.
- Per chi gestisce un negozio, il test utile è un confronto diretto: la stessa domanda di uno shopper, il tuo prodotto contro quello di un concorrente specifico, ripetuto più volte.
- Correggi i dati, pubblica, esegui di nuovo. Una verifica è un'istantanea, una serie di esecuzioni è una prova.
I due significati della valutazione degli LLM nell'ecommerce
L'espressione copre due attività che spesso vengono confuse.
La prima è valutare un LLM che hai messo in produzione: un assistente agli acquisti sul tuo sito che risponde alle domande, suggerisce prodotti e li aggiunge al carrello. Qui scegli il modello, controlli il prompt e puoi vedere ogni conversazione. La domanda è se l'assistente sia davvero valido.
La seconda è valutare come gli agenti AI di terze parti per gli acquisti trattano il tuo negozio. Non scegli tu il modello. Lo sceglie l'acquirente, spesso senza saperlo. L'agente non vede mai la tua homepage. Legge il feed dei prodotti, il catalogo e i dati strutturati nelle schede prodotto, poi decide quale prodotto mostrare all'acquirente. La domanda è se i tuoi prodotti superano questo processo.
La maggior parte del lavoro accademico riguarda la prima attività. Vale comunque la pena leggerlo anche per la seconda, perché mostra che aspetto ha un'attività di shopping quando viene valutata correttamente e dove i modelli inciampano.
Che cosa testano davvero i benchmark
Un ricercatore di Rezolve ha pubblicato un paper per il workshop RecSys 2026 che mette a confronto 12 modelli come agenti conversazionali per gli acquisti nell'intero ciclo di ricerca, chiarimento, raccomandazione e aggiunta al carrello. Valuta 1.200 conversazioni (cinque esecuzioni in 20 scenari) usando un LLM giudice con cinque rubriche, oltre a metriche comportamentali lette dalle tracce delle conversazioni. Le rubriche coprono comprensione dell'intento, chiarimento, qualità della raccomandazione, correttezza dell'aggiunta al carrello e grounding. Il grounding è, in parole semplici, la verifica che ciò che l'agente afferma corrisponda ai dati prodotto che ha ricevuto.
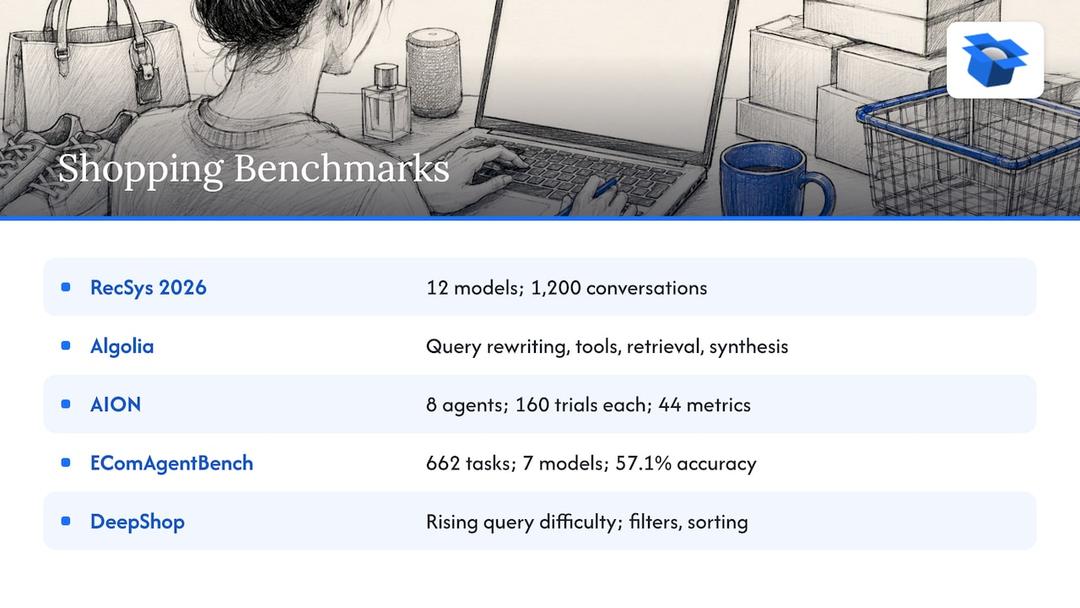
La classifica di Algolia adotta una prospettiva simile dal lato della ricerca. Ogni modello viene eseguito all'interno di un agente di retrieval in produzione e viene valutato su riscrittura delle query, chiamate agli strumenti, recupero e sintesi della risposta, leggendo il testo della risposta, le chiamate agli strumenti e i record recuperati. Quindi il modello viene giudicato come parte di un sistema, non come un concorrente di quiz.
Il paper AION fa un passo in più sul rigore. Costruisce un ambiente di shopping deterministico in cui il profilo del cliente, la difficoltà e il carrello obiettivo di ogni prova sono fissati in anticipo, poi testa otto agenti open-weight con 160 prove ciascuno e 44 metriche. Il punto utile è che un sì o un no alla fine nasconde che cosa è andato storto. Mantenere la traccia degli strumenti e lo stato dell'ambiente consente di distinguere tra azione insufficiente, acquisto eccessivo, attributi prodotto non supportati e ricerca scadente. Sono quattro errori diversi che in apparenza sembrano tutti "l'agente ha sbagliato".
EComAgentBench, dall'Industry Track di EMNLP 2026, usa 662 attività costruite su prodotti e recensioni reali di Amazon. I requisiti sono distribuiti tra una query visibile, un profilo nascosto e un chiarimento scriptato, e l'agente deve scegliere un solo prodotto. Anche il migliore tra sette modelli ha raggiunto solo il 57.1% di accuratezza complessiva, e i risultati peggioravano man mano che i requisiti passavano da fonti visibili a fonti nascoste.
DeepShop, dell'Università di Amsterdam, testa agenti web su query di shopping con difficoltà crescente. La sua conclusione è che il retrieval semplice fatica con le query complesse, e altri metodi inciampano su filtri e preferenze di ordinamento.
Letti insieme, questi paper dicono la stessa cosa con sfumature diverse. Lo shopping è un'attività in più passaggi, gli agenti falliscono in modi specifici e diagnosticabili, e un modello che appare sicuro di sé può comunque scegliere l'articolo sbagliato. Che è più o meno il modo in cui molti di noi fanno acquisti dopo mezzanotte, quindi almeno le macchine risultano comprensibili.
Metriche che contano per un negozio
I ricercatori valutano i modelli. I commercianti devono valutare i risultati. Un mix sensato è questo.
Accuratezza di ciò che l'agente dice sul tuo prodotto. Un paper accademico sugli assistenti conversazionali per gli acquisti definisce l'accuratezza delle informazioni di prodotto per prezzo, disponibilità e caratteristiche, l'accuratezza della fascia di prezzo e l'accuratezza della descrizione delle caratteristiche. Se un agente indica il prezzo sbagliato o inventa una caratteristica, nessuna metrica di ranking salverà la vendita.
Tasso di selezione. Su esecuzioni ripetute della stessa domanda dell'acquirente, quante volte l'agente sceglie il tuo prodotto invece delle alternative? Questo è il numero che interessa di più a chi gestisce un negozio, ed è un tasso, non un sì o un no, perché le risposte del modello variano da un'esecuzione all'altra.
Comportamento dell'intera conversazione. Il paper di Zalando sulla valutazione di agenti in produzione sostiene che bisogna valutare conversazioni intere invece dei singoli turni, perché punteggi aggregati come la pertinenza ti dicono che la qualità è cambiata ma non che cosa abbia fallito o come correggerlo. Per un commerciante questo significa: non limitarti a contare le vittorie, leggi perché hai perso.
Ampiezza, non solo accuratezza. Un paper sulla valutazione di sistemi di raccomandazione multi-obiettivo avverte che ottimizzare solo per l’accuratezza produce sistemi che funzionano peggio nelle condizioni reali, e chiede di misurare anche diversità, copertura ed equità. Per uno store, questo significa controllare l’intero catalogo, non solo i tuoi cinque prodotti di punta.
Una precisazione corretta: nessuna di queste metriche accademiche misura i ricavi. Ti dicono se un agente potrebbe svolgere il compito, non se il saldo in banca se n’è accorto. Accanto a queste, ti servono comunque i tuoi dati sugli ordini.
Quali informazioni devono trovare gli agenti nei tuoi dati
L’indicazione di valutazione meno costosa che conosco è questa: gli agenti confrontano record, non pagine.
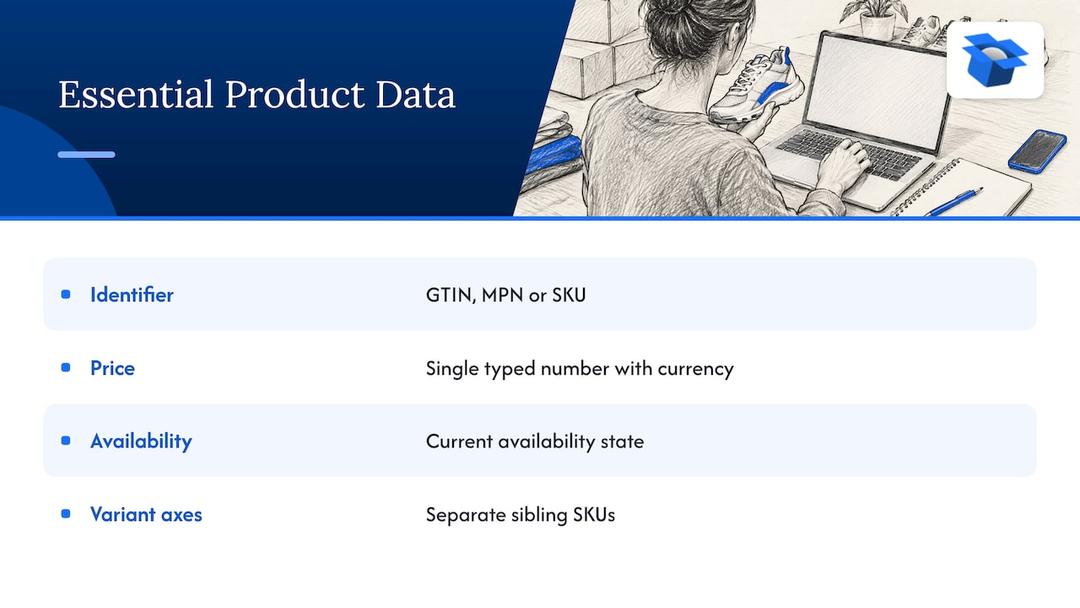
Ecommerce Guide descrive quattro classi di campi che decidono se un articolo può essere confrontato oppure no: un identificatore stabile (GTIN, MPN o SKU), un prezzo aggiornato con valuta, uno stato di disponibilità e gli assi di variante che distinguono uno SKU dagli altri della stessa famiglia. Se ne manca uno, l’articolo esce da un confronto con vincoli. La stessa fonte osserva che il prezzo deve essere un unico numero tipizzato. Un valore di visualizzazione come “a partire da $39” non dà all’agente nulla da verificare rispetto a un budget di $60, quindi l’articolo viene scartato senza far rumore.
Le specifiche sono l’altro punto debole. Un vincolo numerico non si può verificare su un aggettivo. “Leggero” è una sensazione, “1.2 lb” è un valore. La maggior parte dei cataloghi è piena di sensazioni.
Questo corrisponde a ciò che vediamo nelle verifiche. Un marketplace di alcolici da circa €70M l’anno aveva un errore nei dati letti dagli agenti sull’88% dei suoi 9,699 prodotti. Quando agli agenti è stato chiesto dove acquistare due bottiglie che aveva a catalogo, è comparso 0 volte su 20. I checkout per agenti di un brand svedese di skincare sono arrivati al pagamento in 0 Paesi su 6 perché un’impostazione di spedizione richiedeva un numero di telefono. Non farò il nome di nessuno dei due store. Il punto è che nessuno dei due errori era visibile sul sito. Un acquirente umano non se ne sarebbe mai accorto. L’agente se n’è accorto subito e se n’è andato, senza reclami né recensioni.
Se vuoi approfondire il ruolo della scheda prodotto in tutto questo, la nostra guida sulle schede prodotto leggibili dall’AI spiega il markup, e l’articolo su come gli agenti AI per gli acquisti consigliano i tuoi prodotti spiega la logica di selezione.
Come testare il tuo store, passo dopo passo
Non ti serve un laboratorio di ricerca. Ti serve una procedura ripetibile. Questa è quella che userei.
- Scrivi le domande degli acquirenti. Scegli da 10 a 20 domande reali che i tuoi clienti farebbero, con vincoli al loro interno: un budget, una taglia, un caso d’uso, un Paese di consegna. Salta il nome del tuo brand, perché gli acquirenti non lo digitano.
- Scegli un concorrente specifico per ogni prodotto. L’agente sta scegliendo tra opzioni, quindi ti serve un’opzione contro cui poter perdere. Usa il concorrente che compare più spesso quando cerchi tu stesso la categoria.
- Interroga più di un modello, più di una volta. I modelli non sono d’accordo tra loro, e lo stesso modello non è d’accordo con sé stesso. Nelle nostre simulazioni, sullo stesso catalogo, ChatGPT ha scelto il prodotto circa 3 volte più spesso di Claude o Gemini (51.6% contro circa 18.5%). Il verdetto di un singolo modello non è il verdetto del mercato.
- Registra perché ha perso. Un motivo di sconfitta come “il concorrente indica un GTIN, il tuo no” vale più di dieci grafici sulla percentuale di vittorie. Qui vale anche l’argomento di Zalando a favore della lettura di conversazioni complete.
- Correggi i dati, poi riesegui. Modifica una sola classe di problemi alla volta, per esempio prima gli identificatori, poi i prezzi, poi le specifiche, così sai che cosa ha spostato il risultato. Il framework di Zalando usa esecuzioni ripetute per fissare una baseline e confronti a coppie di modifiche isolate, e la logica vale anche su scala del negozio.
- Testa la procedura d'acquisto, non solo la risposta. Vincere la raccomandazione e poi fallire al pagamento è il caso del brand di skincare citato sopra. Percorri il tragitto che seguirebbe un agente: ricerca, carrello, spedizione, pagamento.
Per il passaggio 6 lato Google, il nostro UCP Playground ti permette di testare gli agenti AI per gli acquisti su uno store. UCP è lo standard aperto di Google per il checkout degli agenti. L’acquisto dentro la risposta dell’AI è già attivo oggi su Google AI Mode e Gemini negli Stati Uniti tramite UCP. ChatGPT, invece, rimanda al checkout dello store. OpenAI ha ACP, Google ha UCP, Amazon ha un muro.
Se vuoi dare un’occhiata rapida a come gli agenti leggono la struttura tecnica del tuo sito, c’è anche una audit gratuito WebMCP per lo shopping.
Valutare un chatbot sul tuo sito
Se il tuo vero lavoro corrisponde al primo significato, cioè un assistente di brand sul tuo negozio online, prendi in prestito le abitudini dei benchmark. Testa conversazioni multi-turno, non domande isolate. Controlla ogni prodotto e variante suggeriti rispetto a ciò che ha detto l’acquirente e rispetto a dati prodotto verificati. Controlla che i requisiti resistano alle domande di follow-up. Controlla che cosa succede quando l’articolo è esaurito. È in questi casi che gli assistenti inventano cose.
Ci sono molti esempi di AI nell’ecommerce che mostrano dove gli assistenti sul sito portano davvero valore, e la griglia qui sopra ti dice se il tuo lo fa.
Una precisazione. Un ottimo assistente sul sito non aiuta l’acquirente che non visita mai il tuo negozio. L’agente esterno ha già scelto. Per questo il lavoro sui dati della sezione precedente viene prima, e l’assistente dopo. Credo che l’ordine sia ovvio quando lo si dice ad alta voce, e quasi nessuno lo segue.
Mantenere risultati affidabili nel tempo
I modelli cambiano, i cataloghi cambiano, i concorrenti cambiano i loro feed. Un punteggio di marzo dice poco su novembre.
Tratta la valutazione come un ciclo. Esegui la scansione, leggi i motivi per cui i prodotti perdono, correggi i dati, pubblica, poi eseguila di nuovo. Mantieni fisse le domande degli acquirenti tra un’esecuzione e l’altra, altrimenti stai confrontando esami diversi. Quando aggiungi una nuova linea di prodotti, aggiungi anche le relative domande.
Tieni traccia anche di ciò che puoi davvero osservare: visite dagli assistenti AI nei tuoi analytics e ordini dal tuo lato. Nel nostro primo progetto pilota, DUA Flavours ha registrato un aumento del 12% delle visite dagli assistenti AI e del traffico diretto da aprile a luglio 2026. È un dato sulle visite, non sulle vendite, e preferisco dirlo chiaramente piuttosto che lasciarti supporre il contrario. Le nostre guide su come misurare il traffico degli agenti AI e gli strumenti di attribuzione approfondiscono il lato della misurazione.
Prospettiva: perché testiamo il negozio, non il modello
Ad ottobre 2026 abbiamo eseguito 36.797 acquisti simulati, e la cosa principale che ci hanno insegnato è dove si trova il problema. Raramente è nel modello. È nel feed prodotti, nel catalogo e nella procedura d'acquisto che l’agente deve usare.
Per questo ecentic lavora direttamente sul negozio. Ci colleghiamo a Shopify, WooCommerce o a un feed prodotti e facciamo confrontare a ChatGPT, Claude e Gemini ogni prodotto con quello di un concorrente specifico. Mostriamo in linguaggio semplice perché l’agente sceglie l’altro prodotto. Quando fai clic su Apply, riscriviamo titolo, descrizione e dati strutturati e li pubblichiamo nel tuo negozio.
Su Shopify, inviamo le correzioni a Google Merchant Center e tracciamo le visite dagli agenti AI per gli acquisti. Su WooCommerce, il plugin gratuito di ecentic permette agli agenti di cercare, riempire un carrello e completare il pagamento tramite UCP. È questa parte del checkout che i semplici strumenti per feed non fanno.
Credo che un negozio che aspetta che i modelli migliorino stia facendo una scommessa che non controlla. I modelli miglioreranno, e continueranno comunque a leggere i tuoi dati. Meglio avere dati che vale la pena leggere.
Xhurian Shaba
Esegui il primo test sui tuoi prodotti
Il modo più rapido per vedere i tuoi numeri è la scansione gratuita. Copre i tuoi 10 prodotti principali, non richiede carta di credito e mostra come ChatGPT, Claude e Gemini li confrontano con quelli di un concorrente specifico, e perché perdi quando succede.

Da lì, i piani nella nostra pagina prezzi sono Compete a $14.90 al mese per un massimo di 100 prodotti, Scale a $44.90 al mese per un massimo di 1.000 prodotti con correzioni in un clic, e Dominate a $149 al mese, che aggiunge la sincronizzazione con Google Merchant Center e la configurazione del checkout per agenti. È disponibile anche il modello pay-as-you-go al 3% degli ordini attribuiti all’AI, con un limite massimo di $500 al mese. Se vuoi partire prima dal lato schede prodotto, vedi ottimizzazione delle schede prodotto con AI. Abbiamo anche pagine dedicate per Shopify e WooCommerce anche.
FAQ
Che cos’è la valutazione degli LLM nell’ecommerce?
È il processo con cui si valuta quanto bene un modello linguistico gestisce attività di acquisto come ricerca, domande di chiarimento, raccomandazioni e aggiunta al carrello. Le buone valutazioni analizzano conversazioni complete e verificano le risposte rispetto a dati prodotto reali. Per i merchant, significa anche controllare come gli agenti AI esterni trattano i tuoi prodotti.
Come faccio a sapere se gli assistenti AI raccomandano i miei prodotti?
Fai domande realistiche da acquirente, con budget e vincoli, su più modelli e in più esecuzioni. Conta quante volte il tuo prodotto viene scelto rispetto a quello di un concorrente specifico e annota il motivo quando non accade. Una singola risposta di un singolo chatbot è un aneddoto; una serie ripetuta di esecuzioni è una misurazione.
Di quali dati prodotto hanno bisogno gli agenti AI?
Come minimo, un identificatore stabile come GTIN, MPN o SKU, un prezzo aggiornato con la valuta indicata in un unico valore, uno stato di disponibilità e opzioni di variante chiare. Le specifiche dovrebbero essere valori misurabili, non aggettivi. Senza questi dati, un agente non può confrontare il tuo articolo e tende a scartarlo.
Come integro i dati AI in un negozio ecommerce?
Inizia dal feed prodotti e dai dati strutturati nelle tue pagine prodotto, perché è ciò che gli agenti leggono. ecentic si collega a Shopify, WooCommerce o a un feed prodotti, riscrive titoli, descrizioni e dati strutturati quando fai clic su Apply e li pubblica nel negozio. Poi esegui di nuovo il test per vedere cosa è cambiato.
I punteggi dei benchmark mi dicono come andrà il mio negozio?
Non direttamente. I benchmark mostrano come si comportano i modelli nelle attività di acquisto in generale, e il punteggio massimo di 57,1% di EComAgentBench mostra che c’è ancora molto margine di errore. Il risultato dipende dal tuo catalogo e dai tuoi concorrenti, quindi testa quelli.
Fonti
- Benchmarking dei modelli per l’e-commerce conversazionale (Rezolve, workshop RecSys 2026)
- Algolia LLM Leaderboard: metodologia
- Valutazione di agenti ecommerce open-weight con verifica basata sull’ambiente
- EComAgentBench: benchmark per agenti di shopping (EMNLP 2026 Industry Track)
- DeepShop: un benchmark per agenti di shopping di deep research
- Misurare e migliorare le prestazioni dell’AI negli assistenti per acquisti conversazionali
- E Pluribus Unum: linee guida sulla valutazione multi-obiettivo dei sistemi di raccomandazione
- Valutare e migliorare gli agenti conversazionali in produzione (Zalando)
- Feed prodotto per agenti AI: di cosa hanno bisogno le macchine per confrontare i prodotti
Esplora questi argomenti