

Gemini e Perplexity trovano i prodotti attraverso pipeline quasi completamente diverse. Gemini si appoggia al feed di prodotto, al Merchant Center e all'emergente Universal Commerce Protocol (UCP); Perplexity si appoggia a pagine scansionabili e alla frequenza con cui altri siti ti citano. Entrambi verificano comunque gli stessi segnali chiave: schema completo, prezzo e inventario coerenti, e recensioni reali. Se devi sistemare una sola cosa per prima, fai in modo che sia Product JSON-LD renderizzato lato server con parità del feed sulle SKU più vendute.
In breve:
- Dai priorità a Product JSON-LD renderizzato lato server con schema completo, prezzi coerenti e aggiornamenti quotidiani del feed per garantire visibilità in Gemini e Perplexity.
- Correggi incoerenze di inventario e prezzi, soprattutto sulle SKU con maggior fatturato, per evitare che i prodotti escano dai risultati degli agenti a causa dei segnali di affidabilità.
- Evita l'iniezione dello schema lato client e misure troppo rigide di blocco dei bot, che possono escludere silenziosamente i tuoi prodotti dall'indicizzazione degli agenti AI.
- Usa strumenti di simulazione per individuare lacune nello schema e testare le correzioni sui prodotti ad alto impatto prima di distribuire aggiornamenti all'intero catalogo.
- Monitora regolarmente metriche operative come la completezza degli attributi e le discrepanze di inventario per mantenere e migliorare nel tempo la visibilità verso gli agenti AI.
Indice dei contenuti
- Come Gemini e Perplexity trovano i prodotti (e perché questo cambia tutto)
- Checklist delle priorità: schema, feed, inventario e recensioni
- Shopify vs WooCommerce: passaggi di implementazione e problemi più comuni
- Testare e misurare la visibilità negli agenti
- Perché la simulazione batte le ipotesi
- Fatti consigliare da Gemini e Perplexity senza andare a tentativi
- Fonti
- FAQ
Come Gemini e Perplexity trovano i prodotti (e perché questo cambia tutto)
I risultati shopping di Gemini arrivano da una pipeline di dati, non da una pagina che capita di scansionare. Preleva i dati dal tuo feed Merchant Center, li confronta con lo Shopping Graph di Google e, sempre più spesso, interroga direttamente gli endpoint UCP quando uno store li supporta. Se nel tuo feed mancano i GTIN, i prezzi non sono aggiornati o ci sono segnalazioni di disapprovazione, Gemini semplicemente non mostrerà il prodotto, per quanto bella possa essere la tua scheda prodotto.
Perplexity funziona più come un assistente di ricerca che come un motore per lo shopping. Esegue ricerche web in tempo reale, legge il tuo HTML effettivo, analizza qualsiasi schema presente nella pagina e valuta quanto spesso siti indipendenti, recensioni e forum menzionano il tuo prodotto. Perplexity privilegia la ricerca web in tempo reale e le citazioni di terze parti, il che significa che un prodotto senza menzioni stampa e con uno schema scarno nella pagina può perdere contro un concorrente con prezzi peggiori ma una copertura editoriale migliore.
Entrambi gli agenti si basano in ultima analisi sui dati strutturati, invece di leggere una pagina come farebbe un acquirente. Gli agenti interrogano feed strutturati, schema prodotto e dati del catalogo indicizzati e confrontano questi dati con i vincoli indicati dall’acquirente, come “sotto i 50 $” o “consegna entro venerdì”. Ecco dove si differenziano:
- Gemini premia la completezza del feed, una buona gestione del Merchant Center e il supporto del protocollo UCP.
- Perplexity premia HTML accessibile alla scansione, schema a livello di pagina e citazioni di terze parti.
- Entrambi controllano lo schema Product, i dati Offer, lo stato di disponibilità e i punteggi aggregati delle recensioni.
- Gemini è più vicino a una query su database; Perplexity è più vicino a una ricerca in tempo reale.
Ecco la parte importante per stabilire le priorità: questi agenti coincidono per circa l’80% in ciò che richiedono davvero. Schema pulito, feed accurati e recensioni autentiche servono a entrambi.
Checklist prioritaria: schema, feed, inventario e recensioni
Procedi in questo ordine. Ogni elemento sblocca il successivo e saltare avanti significa solo rifare il lavoro più tardi.
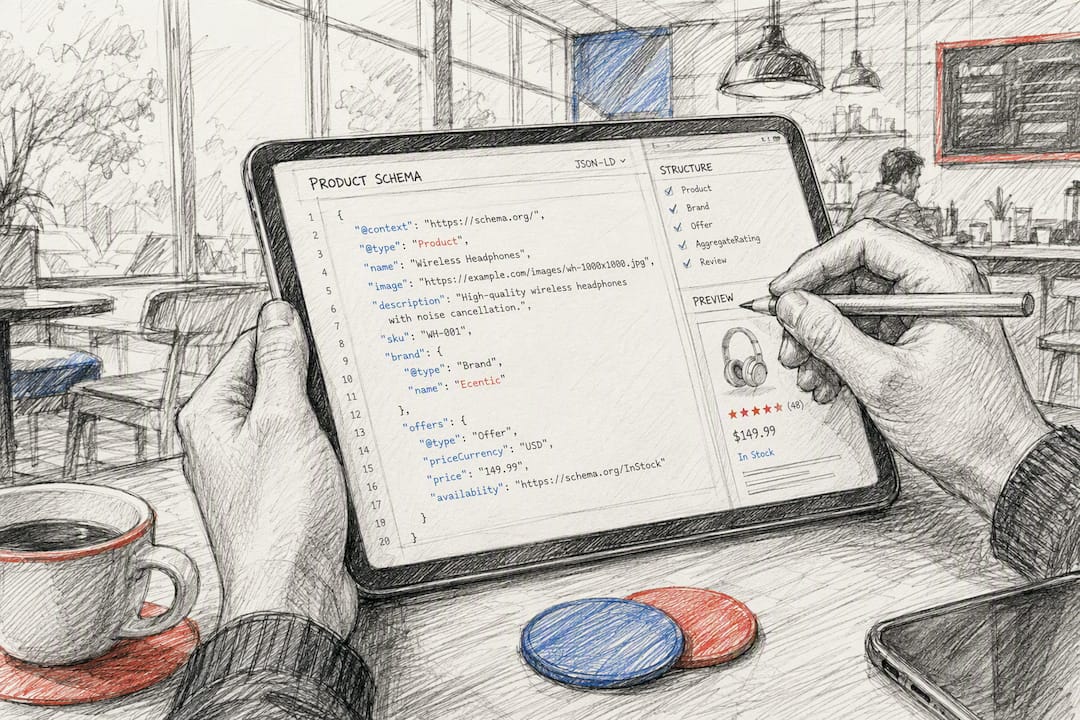
- Distribuisci Product JSON-LD renderizzato lato server. Ogni SKU principale deve avere
name,description,sku,brand,offers,aggregateRating,image, e uno dei due identificatori:GTINoppureMPNpresenti nella risposta HTML grezza, non iniettati dopo il caricamento della pagina. Uno schema Product completo renderizzato lato server è necessario per un parsing affidabile da parte degli agenti, e spesso basta un campo mancante per escludere completamente un prodotto dalla selezione. - Mantieni il prezzo coerente ovunque. Il feed, la scheda prodotto e il checkout devono mostrare lo stesso valore. Gli agenti confrontano prezzi tra feed, PDP e checkout, e una discrepanza viene interpretata come un problema di affidabilità, non come un errore di arrotondamento.
- Aggiorna il feed almeno una volta al giorno. Categorie ad alta rotazione, taglie abbigliamento, drop limitati e flash sale richiedono aggiornamenti quasi in tempo reale. Un aggiornamento giornaliero è il minimo indispensabile, non l’obiettivo.
- Mostra la disponibilità in tempo reale. Compila
Availabilityin modo accurato e, se puoi supportare un endpoint API del catalogo, fallo. I merchant che espongono un endpoint compatibile con UCP ottengono un vantaggio iniziale in termini di visibilità semplicemente perché pochi concorrenti lo fanno già. - Standardizza la tassonomia e completa gli attributi di categoria. Taglia, materiale, colore, vestibilità: qualsiasi attributo richiesto dalla tua categoria deve essere presente e coerente, non sparso in descrizioni testuali libere.
- Pubblica lo schema
MerchantReturnPolicyeShippingDeliveryTime. Questi due elementi vengono saltati continuamente, ma gli agenti li usano per rispondere alle domande esatte degli acquirenti: “posso restituirlo?” e “arriverà entro venerdì?”.
Inizia tutto questo processo dai prodotti con il fatturato più alto, non dall’intero catalogo. Verificare prima il 20% degli SKU che genera più ricavi produce risultati visibili rapidamente e ti offre un modello da automatizzare sul resto del catalogo.
Consiglio pratico: Qui la qualità dei dati strutturati conta più del redesign visivo, ogni volta. Una scheda prodotto visivamente datata ma con uno schema impeccabile verrà raccomandata più spesso di una pagina dal design perfetto ma con markup disordinato, perché gli agenti valutano il livello dati, non la tua palette colori.
Shopify vs. WooCommerce: passaggi di implementazione e problemi comuni
La checklist sopra è indipendente dalla piattaforma. L’esecuzione no.
Su Shopify, verifica se il tuo piano supporta le funzionalità emergenti per storefront con agenti AI, poi conferma che il tema renderizzi JSON-LD lato server invece di usare un’app che lo inietta lato client dopo il caricamento della pagina. Sincronizza il feed prodotto con Merchant Center direttamente dall’admin di Shopify invece di usare esportazioni di terze parti che seguono una propria pianificazione. Controlla anche le regole di CDN e firewall: alcune impostazioni anti-bot bloccano di default i crawler degli agenti, eliminandoti silenziosamente dai risultati di Perplexity senza alcun messaggio di errore.
Su WooCommerce, preferisci un plugin schema PHP lato server o un’iniezione diretta nel template invece di soluzioni che dipendono esclusivamente da Google Tag Manager. Configura un’automazione del feed davvero affidabile: le esportazioni CSV manuali diventano obsolete rapidamente, ed è proprio questa deriva che distrugge la parità del feed. Se le dimensioni del catalogo lo consentono, esponi un endpoint API del catalogo così gli agenti che interrogano direttamente UCP possono accedere al tuo inventario senza attendere il ciclo di aggiornamento del feed.
Tre errori ricorrono continuamente su entrambe le piattaforme:
- Iniezione dello schema solo lato client. I tag che si attivano dopo il caricamento iniziale della pagina spesso sono completamente invisibili ai crawler degli agenti, perché molti non eseguono JavaScript come farebbe un browser.
- Ritardi del feed che creano discrepanze nell’inventario. Un feed aggiornato ogni 48 ore mostrerà regolarmente come disponibili articoli già esauriti.
- Livelli di protezione anti-bot troppo aggressivi. I blocchi CAPTCHA e le regole restrittive di
robots.txtcreate per fermare gli scraper bloccano spesso proprio gli agenti da cui vuoi che i tuoi prodotti vengano consigliati.
Un generatore gratuito di schema JSON-LD è un modo rapido per verificare che la struttura del markup sia corretta prima di investire tempo di sviluppo in un rollout completo. Inoltre, esegui la tua checklist dei dati strutturati su un campione di pagine prima di dare per scontato che la correzione abbia funzionato.
Testare e misurare la visibilità degli agenti
Correggere schema e feed è solo metà del lavoro. Hai bisogno di prove che abbia funzionato e di un metodo ripetibile per intercettare regressioni prima che ti costino traffico.
- Esegui prima le simulazioni. Testa gli SKU prioritari con uno strumento come UCP Playground e registra se l’agente restituisce dati accurati su prezzo, disponibilità e citazioni per ogni query.
- Esegui query manuali come controllo di coerenza. Scegli da 10 a 15 SKU ad alto valore, chiedi direttamente a Gemini e Perplexity informazioni su di essi e confronta le risposte con la tua PDP e il feed live.
- Segmenta le analytics per origine dell’agente. Crea segmenti GA4 per referrer noti come perplexity.ai, chatgpt.com e copilot.microsoft.com (fonti comuni di referral degli agenti) e usa tagging UTM per qualsiasi referral a livello di protocollo che riesci a catturare.
- Monitora settimanalmente le metriche operative, non solo i numeri di conversione.
| Metrica | Cosa ti indica |
|---|---|
| Tasso di disapprovazione del feed | Quanti prodotti sono invisibili a Gemini in questo momento |
| % di completezza degli attributi | Quanto il tuo catalogo è vicino a una copertura completa dello schema |
| Incidenti di discrepanza inventario/settimana | Se la frequenza di aggiornamento sta davvero reggendo |
| Tasso di aggiunta al carrello da referral degli agenti | Se la visibilità sta convertendo, non solo generando visite |
Tracciare correttamente il traffico AI per lo shopping è ciò che trasforma questo da una correzione occasionale a un programma continuo che puoi difendere in una riunione di budget.
Perché la simulazione batte le supposizioni
La maggior parte dei merchant scopre nel modo peggiore che i propri prodotti sono invisibili agli agenti AI: notando traffico che non arriva mai invece di individuare la causa reale. Secondo ecentic, questo approccio è al contrario. Dovresti sapere quale campo dello schema, quale attributo del feed o quale problema di parità sta causando l’esclusione prima di spendere ore di sviluppo andando a tentativi.
I test guidati dalla simulazione fanno emergere il punto esatto del problema. Esegui una query su un prodotto in un ambiente controllato e vedi esattamente ciò che vede un agente, non ciò che pensi veda. Questa differenza separa la correzione dei cinque campi giusti sui tuoi 20 SKU principali questa settimana dall’invio di un aggiornamento ampio dello schema il prossimo trimestre sperando che funzioni. I clienti che usano questo approccio riportano aumenti misurabili di visite e vendite generate dall’AI una volta risolti i problemi specifici identificati dalla simulazione.
La sequenza operativa che funziona è questa: esegui una simulazione mirata sugli SKU con il fatturato più alto, verifica che le correzioni cambino davvero la risposta dell’agente, poi automatizza lo stesso modello di correzione sul resto del catalogo. Saltare la fase di validazione è il modo in cui i team finiscono per rifare lo stesso schema due volte.
— Xhurian
Ottieni raccomandazioni da Gemini e Perplexity senza andare a tentativi
Interrogare manualmente gli agenti per ogni SKU non è scalabile, e i consigli SEO generici non ti diranno quale campo specifico ti sta costando una raccomandazione. ecentic esegue query simulate degli agenti sulle tue vere pagine prodotto e poi ti fornisce un elenco in linguaggio semplice di ciò che non va: un aggregateRatingmancante, un prezzo del feed che non corrisponde alla tua PDP, un campo dello schema che un agente sta ignorando silenziosamente.

La piattaforma si collega direttamente a Shopify o WooCommerce, analizza le tue schede prodotto, e genera correzioni che puoi pubblicare con un clic invece di inserirle in una coda di sviluppo. Hai anche accesso diretto a UCP Playground per testare come Gemini e Perplexity rispondono davvero ai tuoi SKU principali prima e dopo le modifiche, così misuri il comportamento reale degli agenti invece di presumere che le correzioni abbiano funzionato.
Inizia con la scansione gratuita, individua le correzioni a maggiore impatto e testale con query live degli agenti prima di estendere il rollout all’intero catalogo.
Fonti
- Ottimizzare per gli agenti AI per gli acquisti: come rendere i tuoi prodotti visibili agli assistenti AI
- Confronto tra agenti AI per gli acquisti: ChatGPT, Gemini, Perplexity, Copilot, Claude e Rufus (2026)
- Agentic Commerce: guida pratica per rendere i tuoi prodotti visibili, acquistabili e raccomandati dagli agenti AI per gli acquisti - YesTupa
FAQ
Perplexity è migliore di Gemini per le raccomandazioni di prodotto?
Nessuno dei due è strettamente migliore. Gemini funziona al meglio quando il feed e i dati del Merchant Center sono puliti, mentre Perplexity privilegia pagine ben strutturate supportate da citazioni di terze parti. La scelta giusta dipende quindi da quale segnale il tuo store gestisce meglio in questo momento.
Qual è la differenza tra ChatGPT e Gemini per lo shopping?
ChatGPT e Gemini si basano entrambi su dati strutturati del catalogo, ma i risultati shopping di Gemini sono più strettamente collegati al feed Merchant Center e allo Shopping Graph di Google, mentre ChatGPT si appoggia maggiormente alla scansione generale del web e alle citazioni, in modo più simile all’approccio di Perplexity.
Ho bisogno di ottimizzazioni separate per Gemini e Perplexity?
Per lo più no. I due agenti condividono circa l’80% degli stessi requisiti di base — schema pulito, feed accurati e recensioni autentiche — quindi correggere questi aspetti copre gran parte del lavoro per entrambi.
Con quale frequenza dovrei aggiornare il feed prodotto?
Gli aggiornamenti giornalieri sono il minimo per cataloghi stabili, mentre inventari ad alta rotazione come abbigliamento o drop limitati richiedono aggiornamenti quasi in tempo reale per evitare che gli agenti indichino come disponibili articoli già esauriti.
Posso testare come Gemini e Perplexity vedono i miei prodotti prima di pubblicare le modifiche?
Sì. Eseguire gli SKU prioritari tramite uno strumento di simulazione come UCP Playground ti mostra esattamente come un agente interpreta il tuo schema attuale e i dati del feed prima di impegnarti in un rollout completo.
Esplora questi argomenti