

I sistemi AI che oggi raccomandano prodotti attingono da quattro livelli: feed e API dei merchant, dati strutturati nelle schede prodotto, schede prodotto di retailer e marketplace, e recensioni, oltre al comportamento first-party degli acquirenti. I merchant dovrebbero dare subito priorità a tre aspetti: un catalogo canonico con ID stabili, prezzo e disponibilità strettamente sincronizzati e descrizioni di prodotto chiare e ricche di attributi. Dopo questo, i test basati su prompt confermano se queste correzioni cambiano davvero ciò che un agente AI per gli acquisti raccomanda.
In breve:
- I feed dei merchant devono includere ID stabili, prezzi sincronizzati e attributi di prodotto ricchi per evitare incoerenze nelle raccomandazioni e migliorare la fiducia dell'AI.
- Il markup dei dati strutturati dovrebbe essere renderizzato lato server, aggiornato e corrispondere al contenuto visibile della pagina per garantire una comprensione accurata da parte dell'AI.
- Test regolari con prompt di acquisto e simulazioni AI reali aiutano a individuare dove i dati di prodotto o le descrizioni causano errori nelle raccomandazioni.
- Mantenere un'unica fonte di verità e far corrispondere in ogni momento i dati di feed, pagina e checkout riduce al minimo il calo delle raccomandazioni dovuto a informazioni non aggiornate o non allineate.
- I segnali comportamentali first-party e le recensioni supportano la personalizzazione, ma non possono prevalere sui fatti fondamentali del prodotto come stato delle scorte o prezzo, che richiedono dati di feed affidabili.
Panoramica: i livelli di verità del prodotto acquisiti dagli agenti AI per gli acquisti
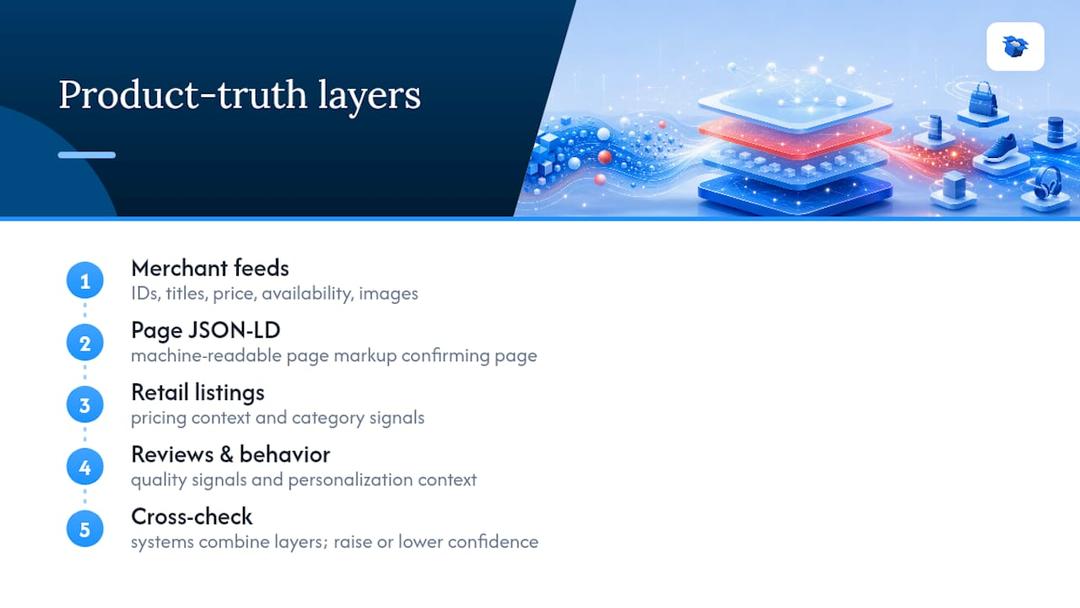
Un agente AI per gli acquisti non vede mai il tuo negozio online come lo vede un acquirente. Vede un insieme frammentato di record e deve decidere di quali fidarsi. Ogni livello fornisce una parte diversa della verità.
Feed e API del merchant contengono i dati portanti: identificatori stabili, titoli, descrizioni, prezzo, valuta, disponibilità, varianti, immagini e informazioni sul venditore. Questo è il livello che la specifica commerciale di OpenAI considera come fonte primaria dei dati di prodotto all'interno di ChatGPT.
Dati strutturati nella scheda prodotto (markup JSON-LD) forniscono ai crawler una versione leggibile dalle macchine di ciò che è già visibile nella pagina, fungendo da seconda conferma di quanto dichiarato nel feed.
Schede prodotto di retailer e marketplace aggiungono contesto di prezzo e segnali di categoria, soprattutto quando un prodotto compare su più canali.
Recensioni e dati comportamentali di prima parte completano il quadro con segnali di qualità e contesto per la personalizzazione, anche se non sostituiscono mai dati oggettivi come lo stato delle scorte.
I sistemi che consigliano prodotti combinano tutti e quattro i livelli e li verificano in modo incrociato. Quando il tuo feed dice “disponibile” e il markup della pagina dice “non disponibile”, questa discrepanza non si limita a confondere l'algoritmo. Riduce la fiducia nell'intero record secondo la specifica sui dati di prodotto di Google.
Best practice per feed di prodotto e API che i merchant devono seguire
Il tuo feed è la risorsa più strategica che controlli direttamente e deve contenere campi specifici, non un generico senso di completezza.
- Includi i campi principali di identità: id stabile o SKU, titolo, descrizione, link canonico, URL dell'immagine, prezzo, valuta, stato di disponibilità, attributi di variante e brand.
- Allineati allo schema flat-file di OpenAI dove vuoi l'idoneità in ChatGPT. La specifica di prodotto Agentic Commerce richiede almeno id, title, description, link, image_link, availability, price e brand.
- Imposta i flag di idoneità in modo consapevole.
is_eligible_searcheis_eligible_checkoutsono interruttori distinti. Una scheda prodotto perfettamente completa non comparirà in ChatGPT se questi flag non sono impostati. - Rispetta i requisiti fondamentali di Google Merchant Center: ID prodotto stabile, link alla landing page funzionante, prezzo e disponibilità accurati, e campi corretti per categoria e identificatori.
- Mantieni i valori del feed identici a quelli della landing page e del checkout. Le discrepanze qui sono una delle cause più comuni di disapprovazione o di perdita silenziosa nelle raccomandazioni.
Suggerimento pratico: Esegui ogni settimana un controllo a campione su 20 SKU casuali confrontando feed, scheda prodotto e procedura d'acquisto. La maggior parte delle derive del feed avviene in silenzio, un aggiornamento di prezzo o una sincronizzazione dell'inventario alla volta, e nessuno se ne accorge finché un agente AI per gli acquisti non comunica a un acquirente il prezzo sbagliato.
Quanto alla frequenza: le categorie ad alta volatilità (abbigliamento con riassortimenti frequenti, elettronica con prezzi dinamici) richiedono aggiornamenti nello stesso giorno o ogni ora. Le categorie con rotazione più lenta possono tollerare sincronizzazioni giornaliere, ma mai oltre.
Dati strutturati nelle pagine prodotto: campi Schema.org e problemi ricorrenti
I dati strutturati sono il modo in cui consegni a un sistema AI i fatti esatti che vuoi che usi, in un formato che non lo costringa a fare ipotesi.
Le proprietà Schema.org essenziali per qualsiasi pagina prodotto includono:
Productcon i campi name, description e imageOfferannidato al suo interno, conprice,priceCurrency, eavailabilitygtin(o la variante GTIN appropriata) per l'identificazione globale del prodottoskuper il tuo identificatore internoitem_group_idper collegare tra loro le varianti dello stesso prodotto
Le indicazioni di Google sugli attributi di dati strutturati supportati sono esplicite: questo markup deve essere presente nell'HTML renderizzato dal server, non inserito solo lato client dopo l'esecuzione di JavaScript. Molti crawler e agenti non eseguono affatto il tuo JavaScript, il che significa che per loro un markup solo JS è di fatto invisibile.
Il problema più comune non è l'assenza del markup. È un markup che in passato era corretto e che, senza dare nell'occhio, ha smesso di essere sincronizzato con la pagina visibile, di solito dopo una variazione di prezzo o la sostituzione di una promozione che ha aggiornato solo la visualizzazione nel front-end.
Consiglio pratico: Il fatto che un validatore di schema dia esito positivo ti dice che la sintassi è corretta. Non ti dice nulla sul fatto che un’AI descriva davvero il tuo prodotto in modo corretto. Abbina i controlli del validatore ad audit reali sui prompt per vedere come viene descritto lo SKU.
Recensioni, segnali del venditore e dati comportamentali proprietari
Le recensioni e i dati comportamentali influenzano il modo in cui un sistema AI personalizza una raccomandazione, ma svolgono un ruolo di supporto, non fondamentale.
- Le recensioni forniscono percezioni sulla qualità e prove d’uso, il tipo di contesto che aiuta un agente a decidere quale prodotto disponibile si adatta alle esigenze dichiarate dell’acquirente.
- I dati comportamentali proprietari raccolti con consenso consentono alle piattaforme di adattare le raccomandazioni al contesto, alla cronologia degli acquisti o ai modelli di navigazione, secondo la ricerca di Klaviyo su AI e comportamento dei consumatori.
- Entrambi i tipi di dati devono essere collegati a un identificatore SKU stabile, altrimenti le prove fornite dalle recensioni e la scheda prodotto corrente finiscono per divergere nel tempo.
- Né le recensioni né i segnali comportamentali dovrebbero mai prevalere sul feed canonico di prezzo o inventario. Se una recensione a cinque stelle dice che un prodotto è un ottimo affare ma il tuo feed lo indica come esaurito, prevale il feed.
Aggiornamento, sincronizzazione e identità: regole per evitare la perdita di raccomandazioni
Dati obsoleti su prezzi e disponibilità non irritano soltanto gli acquirenti. Spingono i sistemi AI a smettere silenziosamente di raccomandare del tutto uno SKU, invece di rischiare una risposta errata.
- Mantieni sempre allineati feed, dati strutturati, landing page e valori del checkout. Qualsiasi discrepanza aumenta il rischio di rifiuto o di perdita di visibilità, secondo le linee guida di Merchant Center di Google.
- Non rinominare né riemettere mai gli SKU durante il processo. La deriva dell’identità, cioè modificare un identificatore durante un redesign del sito o una migrazione del catalogo, è uno dei modi più comuni con cui i merchant interrompono il collegamento tra la cronologia dei prezzi di un prodotto, le sue recensioni e la sua scheda attuale.
- Modella esplicitamente le varianti usando
item_group_idinvece di lasciare che variazioni di colore o taglia esistano come prodotti separati e scollegati. - Imposta la frequenza degli aggiornamenti in base alla volatilità. Un inventario ad alta rotazione richiede controlli orari; gli articoli di catalogo stabili possono seguire un ciclo giornaliero.
- Testa i casi limite, non solo il percorso ideale. Gli stati di preordine, ordine arretrato e prodotto esaurito richiedono lo stesso rigore di verifica delle normali schede con prodotti disponibili.
Consiglio pratico: Crea una piccola dashboard che segnali qualsiasi SKU per cui il prezzo del feed e quello della pagina differiscono da più di due ore. Quasi sempre questo scarto è il primo segnale che qualcosa si è rotto a monte.
Test e misurazione: prompt, simulazioni e attribuzione del traffico
Il fatto che un validatore di schema restituisca un esito positivo non ti dice nulla sul fatto che ChatGPT o Gemini raccomandino davvero il tuo prodotto quando un cliente reale lo chiede. È proprio questo divario a rendere necessario che i test includano l’output reale dell’AI, non solo la struttura dati sottostante.
- Crea un set rappresentativo di prompt. Includi prompt di categoria (“migliori scarpe da running per piedi piatti”), prompt basati sui casi d’uso, prompt con vincoli di budget e prompt di confronto diretto con i concorrenti.
- Esegui i prompt tramite simulazioni di agenti AI e registra se il tuo SKU viene menzionato, se il prezzo citato corrisponde alla realtà e se l’inquadramento risponde all’esigenza dichiarata dell’acquirente.
- Tagga il traffico attribuito all’AI nelle analytics e monitora il tasso di conversione separatamente dal traffico organico o a pagamento.
- Esegui nuove scansioni con regolarità. Le raccomandazioni cambiano in base al prompt, al mercato e allo stato dell’inventario, quindi un buon risultato oggi non garantisce lo stesso risultato la prossima settimana.
Una singola risposta favorevole dell’AI non è un report di ranking. I risultati variano in base alla formulazione del prompt, alla lingua, al mercato e alle scorte disponibili, ed è proprio per questo che l’analisi di NIQ sullo shopping guidato dall’AI descrive il vero cambiamento strategico come il passaggio dalla quota di ricerca alla quota di raccomandazione, qualcosa che deve essere misurato ripetutamente, non una sola volta.
Checklist operativa: passaggi prioritari per i prossimi 7-30 giorni
- Verifica che il catalogo abbia ID stabili e correggi eventuali relazioni tra varianti interrotte o duplicate.
- Sincronizza i valori di feed, pagina e checkout per prezzo, valuta e disponibilità.
- Correggi il markup JSON-LD in modo che venga renderizzato lato server e corrisponda al contenuto visibile della pagina.
- Arricchisci le descrizioni prodotto troppo scarne con attributi concreti e linguaggio orientato ai casi d’uso.
- Esegui un test di simulazione di base sui tuoi 20 SKU principali per vedere il comportamento attuale delle raccomandazioni AI.
| Attività | Responsabile tipico | Metrica di successo |
|---|---|---|
| Verifica degli ID stabili | Responsabile catalogo | Zero SKU duplicati o rinominati |
| Sincronizzazione feed/pagina/checkout | Sviluppatore | Tasso di corrispondenza prezzo/disponibilità |
| Correzioni JSON-LD | Sviluppatore | Il markup corrisponde alla pagina visibile |
| Arricchimento delle descrizioni | Responsabile catalogo | Completezza degli attributi per SKU |
| Test di simulazione | Responsabile marketing/ecommerce | Tasso di menzione degli SKU nell’insieme di prompt |
Come i sistemi AI usano i controlli di idoneità rispetto ai dati di prodotto
Una scheda prodotto completa e accurata e un prodotto idoneo sono due cose diverse, e i merchant le confondono regolarmente.
I dati di prodotto — prezzo, disponibilità, immagini, descrizioni — rispondono alla domanda “cos’è questo prodotto ed è attualmente vendibile in linea di principio?”. I flag di idoneità rispondono a una domanda più ristretta e separata: “questo sistema specifico dovrebbe mostrare o consentire la transazione di questo prodotto specifico in questo momento?”. La documentazione Agentic Commerce di OpenAI separa deliberatamente questi aspetti, con is_eligible_search che controlla la visibilità e is_eligible_checkout che controlla se una transazione può essere completata all’interno dell’agente.
Questa distinzione crea problemi a molti merchant che presumono che correggere il feed risolva automaticamente anche la visibilità. Non è così. Un prodotto con dati perfetti ma con un flag di idoneità non impostato o configurato male semplicemente non comparirà, indipendentemente dalla qualità della scheda sottostante. Vale anche il contrario: un prodotto può essere tecnicamente idoneo ma descritto male, e quindi comparire raramente o essere scartato rapidamente in un confronto.
L’implicazione pratica è che la revisione dell’idoneità richiede una voce separata nella checklist, distinta dalla revisione della qualità dei dati. Considerala come un controllo esplicito, non come una conseguenza automatica di un catalogo pulito. I merchant che operano su più mercati dovrebbero verificare i flag di idoneità per ogni mercato, poiché un flag configurato correttamente per l’invio del feed in una regione non si applica automaticamente ovunque venga distribuito lo stesso catalogo.
Considerazioni su privacy e conformità dei dati per AI e fonti dati shopping
I dati comportamentali proprietari sono l’input di personalizzazione più prezioso a disposizione dei sistemi AI per lo shopping, ma anche il più sensibile dal punto di vista legale.
Il consenso è la base. I segnali comportamentali, la cronologia di navigazione, i modelli di acquisto e le interazioni sul sito possono alimentare modelli di personalizzazione solo quando gli acquirenti hanno effettivamente acconsentito a questo utilizzo, e le regole applicabili variano in base alla giurisdizione (i regimi di protezione dei dati nell’UE, le leggi statali sulla privacy negli Stati Uniti e altri sistemi normativi stabiliscono ciascuno requisiti propri). I merchant che operano su più mercati devono monitorare quale standard di consenso si applica a ciascun segmento di clienti, invece di adottare un’unica policy generalizzata.
Anche la minimizzazione dei dati è importante. Fornire a un sistema AI più dettagli comportamentali di quanti ne richieda realmente un caso d’uso di personalizzazione non migliora in modo significativo le raccomandazioni. Aumenta solo l’esposizione ai requisiti di conformità. La stessa logica vale per i dati delle recensioni: aggregare e anonimizzare i segnali derivati dalle recensioni prima che entrino in una pipeline di raccomandazione riduce il rischio senza ridurne significativamente l’utilità.
La condivisione di dati con terze parti merita un’attenzione particolare. Quando un feed o un’API invia dati degli acquirenti a una piattaforma AI esterna per l’elaborazione, questo trasferimento può di per sé attivare obblighi informativi o contrattuali, a seconda della piattaforma e della giurisdizione. I merchant dovrebbero trattare qualsiasi nuova integrazione con una piattaforma AI per lo shopping come tratterebbero una nuova integrazione con un processore di pagamento: revisione della condivisione dei dati prima del lancio, non dopo.
Sfide di integrazione nella combinazione di più fonti dati per i modelli AI di shopping
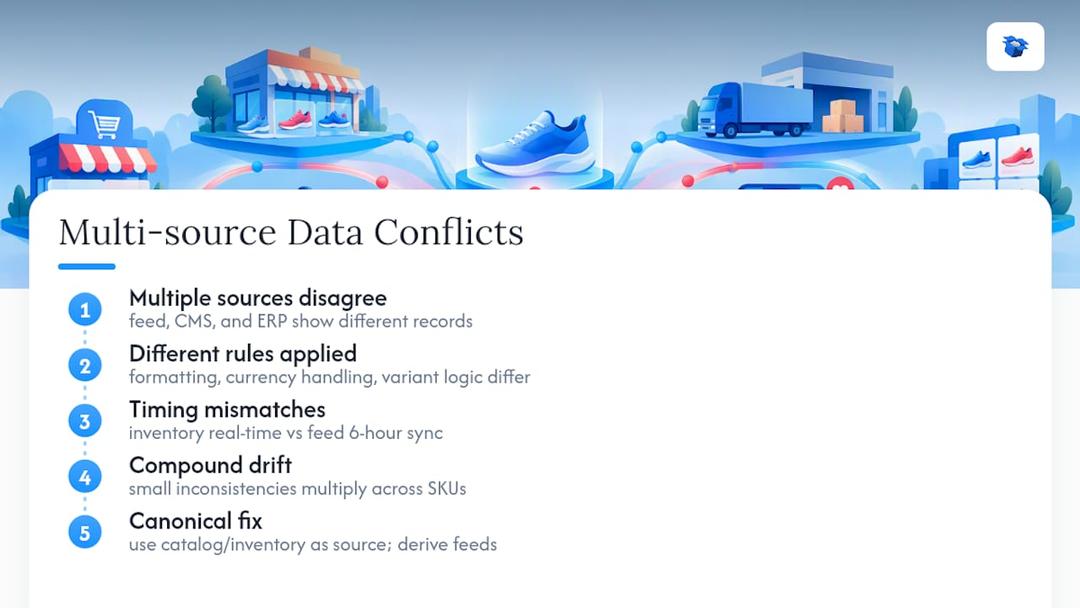
Prima o poi tutti i merchant si scontrano con lo stesso problema: il feed dice una cosa, il CMS un’altra e il sistema ERP non concorda con nessuno dei due.
La sfida principale non è raccogliere i dati. È riconciliare record creati per scopi diversi e mai progettati per essere coerenti tra loro. Un feed costruito per Google Shopping e uno creato per una piattaforma AI commerce possono attingere dallo stesso database sorgente, ma applicare regole di formattazione diverse, una gestione differente della valuta o logiche diverse di raggruppamento delle varianti. Piccole incoerenze si amplificano rapidamente in un catalogo con migliaia di SKU.
Le discrepanze temporali aggravano il problema. Se il tuo sistema di inventario si aggiorna in tempo reale ma il feed si sincronizza solo ogni sei ore, esiste una finestra in cui un agente AI lavora con dati già errati. Le linee guida di Google sui dati strutturati e gli aggiornamenti automatici sono chiare: l’aggiornamento dei dati non è facoltativo, e frequenze di aggiornamento non allineate tra sistemi creano esattamente i conflitti che riducono la fiducia dell’AI in una scheda prodotto.
La soluzione pratica consiste nello stabilire un’unica fonte canonica di verità, di solito il sistema di gestione dell’inventario o del catalogo, e trattare ogni feed downstream come un output derivato invece che come un record mantenuto indipendentemente. Qualsiasi modifica manuale effettuata direttamente in un file feed senza aggiornare il sistema sorgente crea una deriva quasi impossibile da tracciare in seguito. I merchant che usano Shopify o WooCommerce con più canali di vendita dovrebbero verificare in quanti punti risiedono realmente i dati di prezzo e stock prima di dare per scontato che i sistemi siano sincronizzati.
Ruolo dei provider di dati aggregati di terze parti e loro affidabilità
Gli aggregatori che raccolgono dati prodotto da più retailer e li normalizzano in un unico feed svolgono un ruolo reale nell’ecosistema AI per lo shopping, ma la loro affidabilità varia più di quanto la maggior parte dei merchant immagini.
Il vantaggio è semplice: invece di mantenere feed separati per ogni canale, un merchant può inviare un unico feed a un aggregatore e lasciare che redistribuisca all’esterno dati normalizzati. Il rischio è che la normalizzazione sia un processo di traduzione, e ogni traduzione introduce la possibilità di errori. Un aggiornamento di prezzo dal tuo lato potrebbe impiegare più tempo a propagarsi tramite un aggregatore rispetto a un feed diretto, e questo ritardo è esattamente il tipo di obsolescenza che riduce la fiducia dell’AI nelle raccomandazioni.
L’affidabilità dipende molto anche dalla frequenza con cui l’aggregatore stesso si risincronizza con i tuoi dati sorgente, e questa frequenza non è sempre visibile al merchant. Prima di affidarti a un aggregatore come canale principale di distribuzione per la visibilità nello shopping AI, vale la pena verificare che la sua frequenza di aggiornamento corrisponda alla tua volatilità reale, e non solo a una promessa di marketing di sincronizzazione “in tempo reale”.
L’approccio più sicuro consiste nel trattare i dati distribuiti tramite aggregatore come un canale secondario che dovrebbe essere coerente con il feed diretto e il markup della pagina, non come un sostituto della gestione diretta di questi canali. Quando i tre elementi non coincidono, la versione dell’aggregatore è quella di cui un sistema AI ha meno motivi di fidarsi, perché è la più distante dalla fonte originale.
Impatto della qualità dei dati sulle raccomandazioni AI nei contesti di shopping
La qualità dei dati non influisce solo sul fatto che un sistema AI trovi il tuo prodotto. Determina se il sistema si fida abbastanza da raccomandarlo rispetto alla scheda di un concorrente.
Un prodotto può essere tecnicamente individuabile, indicizzato, idoneo al feed e strutturalmente valido, e perdere comunque opportunità di raccomandazione perché gli attributi sono incompleti, le varianti ambigue o il prezzo è diventato silenziosamente obsoleto. Le specifiche commerce di OpenAI lo spiegano chiaramente: misurare soltanto la validità dei dati non basta, perché i risultati osservati nelle raccomandazioni possono divergere da quanto prevederebbe un semplice controllo dello schema.
Dati in conflitto tra fonti diverse aggravano il problema. Quando il tuo feed, il markup della pagina e la scheda di un rivenditore descrivono lo stesso prodotto in modo leggermente diverso, un sistema AI non fa una media delle differenze. Interpreta la discrepanza come un segnale di inaffidabilità, riducendo la fiducia complessiva in ogni campo associato a quello SKU, come conferma di fatto la specifica di Merchant Center di Google con l’importanza che attribuisce alla coerenza tra fonti.
Qui l’effetto cumulativo è cruciale. Un singolo attributo debole raramente compromette da solo una scheda prodotto. Ma un catalogo con decine di piccole incoerenze — un prezzo obsoleto qui, un attributo variante mancante lì, una descrizione che non menziona mai un caso d’uso chiave — si trasforma in un modello che i sistemi AI imparano a declassare. Migliorare la qualità dei dati non è un progetto di pulizia una tantum. È una disciplina continua che genera benefici cumulativi quanto più a lungo viene mantenuta.
Prospettiva editoriale: perché la simulazione supera la sola validazione
I validatori di schema confermano la sintassi. Non possono dirti che un agente AI ignora il tuo prodotto perché la descrizione nasconde proprio l’attributo che l’acquirente ha richiesto. La simulazione rivela questo divario, e un ciclo di diagnosi, riscrittura, pubblicazione e nuovo test lo colma più rapidamente di qualsiasi audit statico. I merchant che ripetono regolarmente questo ciclo tendono a intercettare derive, discrepanze di prezzo, descrizioni scarne e varianti ambigue prima che costino un’intera stagione di raccomandazioni perse, non dopo.
— Xhurian
Come ecentic trasforma le correzioni dei dati in vittorie nelle raccomandazioni AI
Correggere feed e markup in isolamento è un lavoro alla cieca se non hai un modo per vedere come ChatGPT, Gemini o Perplexity rispondono realmente al tuo catalogo in questo momento. Alcune piattaforme chiudono questo ciclo: simulano prompt di shopping reali sul tuo store, mostrano esattamente dove una scheda prodotto vince o perde rispetto ai concorrenti in linguaggio semplice e ti permettono di pubblicare direttamente la correzione su Shopify o WooCommerce con un clic.

UCP Playground ti permette di testare qualsiasi store con agenti AI per gli acquisti prima di impegnarti in una riscrittura, così sai quali SKU richiedono attenzione invece di andare a tentativi. Una volta individuate le lacune, gli strumenti di ottimizzazione delle schede prodotto di ecentic strumenti di ottimizzazione delle schede prodotto generano la correzione e la pubblicano, quindi eseguono una nuova scansione per confermare che il tasso di raccomandazione sia effettivamente cambiato.
Inizia con una scansione gratuita per vedere lo stato attuale del tuo catalogo, poi confronta i piani nella pagina prezzi, che elenca diverse opzioni di abbonamento insieme a una commissione sulle prestazioni per ogni ordine attribuito all’AI.
Specifiche e documentazione autorevoli da consultare
Per dettagli di implementazione oltre questa guida, vai direttamente alle fonti originali. Le specifiche OpenAI Agentic Commerce coprono struttura del feed e idoneità, mentre la documentazione Google sui dati strutturati tratta la validazione del markup e le proprietà richieste per un’individuazione accurata.
Fonti
Le immagini e le descrizioni in testo libero contengono informazioni reali utilizzate dai sistemi AI, ma sono più difficili da validare rispetto a un campo strutturato come il prezzo, e questo divario crea punti ciechi che i merchant spesso non notano.
Le immagini di prodotto fanno più che decorare una scheda. I sistemi AI multimodali possono estrarre attributi direttamente dalle immagini — colore, texture del materiale, dimensioni approssimative rispetto ad altri oggetti presenti nell’inquadratura — quando i campi strutturati degli attributi sono mancanti o incompleti. È utile, ma significa anche che un’immagine stock generica o di bassa qualità può lavorare attivamente contro di te, fornendo segnali visivi vaghi o fuorvianti laddove un attributo testuale chiaro sarebbe stato più affidabile.
Le descrizioni in testo libero comportano un rischio simile nella direzione opposta. Una descrizione scritta per la densità di keyword SEO anziché con un linguaggio chiaro sugli attributi (“qualità premium, migliore della categoria, valore incredibile”) offre a un sistema AI pochissimi elementi concreti da estrarre. Una descrizione che specifica materiale, dimensioni e caso d’uso preciso fornisce invece molti più dati utili, anche senza il supporto di un singolo campo strutturato.
L’approccio pratico consiste nel trattare i contenuti non strutturati come un’integrazione dei dati strutturati, mai come un sostituto. Scrivi descrizioni che indichino attributi concreti in linguaggio semplice e usa immagini che mostrino chiaramente gli attributi di prodotto rilevanti per la categoria — riferimenti dimensionali per i mobili, texture per i tessuti, scala per l’elettronica. Dove esistono campi strutturati, assicurati che testo e immagini non li contraddicano.
FAQ
Ho bisogno sia di un feed prodotto sia del markup dei dati strutturati?
Sì. Feed e dati strutturati servono sistemi diversi e fungono da verifica reciproca; affidarsi solo a uno dei due lascia lacune che gli agenti AI possono interpretare come incoerenze. Le specifiche di Google sui dati di prodotto considerano i valori coerenti tra entrambi un requisito di base, non un’opzione.
Con quale frequenza dovrei aggiornare i dati su prezzo e disponibilità?
La frequenza degli aggiornamenti dovrebbe riflettere la rapidità con cui cambiano i dati: ogni ora o in giornata per le scorte ad alta rotazione, almeno una volta al giorno per gli articoli stabili del catalogo. Secondo le linee guida di Merchant Center di Google, i valori non aggiornati sono una delle cause più comuni per cui i prodotti perdono le raccomandazioni dell’AI.
Le recensioni possono sostituire la necessità di dati accurati nel feed?
No. Le recensioni forniscono segnali di qualità e casi d’uso, ma non sostituiscono mai i dati autorevoli su prezzo o inventario, che restano responsabilità del feed indipendentemente dalla forza del segnale delle recensioni.
Come posso testare ciò che gli agenti AI raccomandano davvero per i miei prodotti?
Crea un insieme rappresentativo di prompt di shopping che copra scenari di categoria, budget e confronto, poi eseguili tramite una simulazione di agenti come UCP Playground di Ecentic per vedere direttamente le menzioni degli SKU e l’accuratezza dei prezzi.
Quanto costa Ecentic per un piccolo store ecommerce?
Il piano Compete di Ecentic parte da $14.90 al mese, Scale da $44.90 e Dominate da $149, più un’opzione pay-as-you-go con una commissione del 3% per ogni ordine attribuito all’AI, tutti indicati nella pagina prezzi.