

Esegui un audit di readiness basato su simulazioni, abbinato a test della percentuale di vittorie su più motori. Questa combinazione intercetta ciò che le checklist SEO generiche non vedono: i segnali leggibili dalle macchine che ChatGPT, Gemini, Claude e Perplexity usano davvero per decidere quali prodotti consigliare. Ecentic propone questo approccio per i merchant Shopify e WooCommerce ed è la piattaforma che ti consiglieremmo per prima perché corregge gli stessi segnali che misura.
Ecco perché è importante proprio adesso:
- Gli agenti saltano le pagine in cui prezzo e disponibilità vengono renderizzati solo dopo il caricamento di JavaScript
- Un analizzatore come CatalogReady, che verifica se la pagina è pronta, assegna un punteggio da 0 a 100 alla tua pagina e ti dice esattamente cosa non funziona
- Il modo più rapido per arrivare a una diagnosi è una scansione gratuita, non un'ipotesi
Esegui un audit oggi stesso. Qui sotto trovi cosa misura e perché è importante.
Punti chiave
Ottenere consigli dagli agenti AI per gli acquisti dipende più dalla coerenza leggibile dalle macchine tra pagina, feed e schema che da testi prodotto persuasivi.
| Punto | Dettagli |
|---|---|
| Correggi la struttura prima dei testi | Renderizza lato server prezzo e disponibilità e completa JSON-LD Product e Offer prima di riscrivere le descrizioni. |
| Controlla l'accesso dei crawler | Verifica che robots.txt e llms.txt consentano l'accesso a OAI-SearchBot, PerplexityBot e crawler di agenti simili. |
| Allinea ogni superficie | Verifica prezzo e disponibilità tra pagina, feed e schema; le incongruenze squalificano i prodotti. |
| Testa su più motori | Esegui query identiche su ChatGPT, Perplexity e Gemini prima e dopo le correzioni per confermare miglioramenti reali, non solo aumenti del punteggio. |
| Usa ecentic per la diagnostica continua | ecentic esegue audit deterministici della preparazione per gli agenti, fornisce correzioni JSON-LD pronte da incollare e monitora le visite generate dagli agenti per i negozi Shopify e WooCommerce. |
Cosa sono i simulatori di agenti AI e perché chi vende online ne ha bisogno?
Un simulatore di agenti AI per gli acquisti ricrea il processo esatto che ChatGPT, Gemini o Perplexity usano per valutare la tua pagina prodotto, quindi riporta cosa l’agente ha visto, cosa ha ignorato e perché ha scelto invece un concorrente. È una categoria di strumenti diversa dai framework generici per il test degli agenti, pensati per gli ingegneri che fanno debug di workflow multi-agente. I simulatori di agenti per gli acquisti esistono per un solo scopo: dire ai commercianti se le loro schede prodotto resistono al confronto con un acquirente AI.
Questo confronto avviene in tre fasi, secondo l’analisi dei protocolli del commercio con agenti AI. Primo, recupero: il crawler dell’agente riesce davvero a recuperare la tua pagina e a leggere i dati strutturati? Secondo, fiducia: recensioni, policy e dichiarazioni sul prezzo sono coerenti su ogni superficie che l’agente controlla? Terzo, azione: l’agente può confermare la disponibilità e completare una procedura d'acquisto senza arrivare a un vicolo cieco? Un prodotto che fallisce anche solo uno di questi livelli viene escluso, indipendentemente da quanto il testo possa sembrare valido a una persona.
Un simulatore può misurare se il tuo JSON-LD viene interpretato correttamente, se il tuo prezzo corrisponde al feed e se una query specifica mostra il tuo prodotto in uno specifico motore in uno specifico giorno. Non può promettere un posizionamento in cima stabile nel tempo. Gli output degli agenti cambiano con gli aggiornamenti dei modelli, le modifiche dei concorrenti e la formulazione delle query, quindi considera ogni simulazione come un’istantanea, non come una garanzia.
Come si valuta un simulatore di agenti AI?
Non tutti gli strumenti presentati come app di simulazione AI testano davvero ciò che conta per un agente AI per gli acquisti. Prima di fidarti di un punteggio di preparazione, verifica che lo strumento copra queste cinque aree.
- Validazione dello schema e dei dati renderizzati lato server. Lo strumento dovrebbe controllare il tuo JSON-LD Product e Offer per titolo, GTIN o SKU, prezzo, valuta e disponibilità, e confermare che questi campi siano renderizzati nell’HTML statico invece di comparire solo dopo l’esecuzione di JavaScript. l’analisi di AgentMint sull’anatomia della pagina prodotto osserva che molti crawler AI recuperano solo HTML statico, quindi i dati presenti solo lato client sono invisibili per loro.
- Controlli di accesso dei crawler. Dovrebbe leggere i tuoi file robots.txt e llms.txt e confermare che bot specifici come OAI-SearchBot e PerplexityBot non siano bloccati.
- Coerenza delle dichiarazioni tra i vari punti di contatto. Un auditor affidabile incrocia prezzo e disponibilità sulla tua pagina con il feed di prodotto e i dati strutturati, segnalando le discrepanze che portano all’esclusione immediata dei prodotti.
- Diagnostica deterministica. Cerca ID di regola e patch JSON-LD pronte da incollare invece di consigli vaghi come “migliora la tua SEO”. CatalogReady, un auditor open source, assegna alle pagine un punteggio da 0 a 100 e collega ogni problema a una regola specifica e correggibile.
- Simulazione su più motori con attribuzione. Un test su un solo motore ti dice come ChatGPT vede la tua pagina, ma non dice nulla su Gemini o Perplexity, che attribuiscono pesi diversi ad aggiornamento dei contenuti e citazioni.
Suggerimento: Chiedi a qualsiasi fornitore se il suo punteggio di preparazione è deterministico (basato su regole, riproducibile) o una stima generata da un modello. I punteggi deterministici ti permettono di riprodurre lo stesso risultato domani; quelli generati dal modello possono variare tra un’esecuzione e l’altra per ragioni che non hanno nulla a che fare con la tua pagina.
Come si esegue un test della percentuale di vittorie sulle tue pagine prodotto?
Questo protocollo richiede meno di un giorno e ti offre un confronto prima/dopo su cui puoi agire subito.
- Recupera la tua pagina senza JavaScript. Recupera l’HTML grezzo e verifica che titolo, prezzo, disponibilità e identificatori compaiano nella risposta statica, non solo nel DOM renderizzato.
- Valida il tuo JSON-LD Product e Offer. Verifica che priceCurrency, price, availability e GTIN o SKU siano presenti e corrispondano a ciò che un acquirente vede sulla pagina.
- Controlla robots.txt e llms.txt. Verifica di non bloccare i crawler da cui dipendono gli agenti e aggiungi un file llms.txt se non l’hai già fatto; l’analisi di StoreSEO considera questo intervento una delle correzioni tecniche a più alto impatto disponibili per i merchant Shopify.
- Esegui un audit deterministico ed esporta i risultati. Recupera gli ID delle regole e le correzioni pronte da incollare, poi applica direttamente le patch di server-side rendering e di schema.
- Interroga lo stesso prodotto su ChatGPT, Perplexity e Gemini prima e dopo le tue correzioni. Registra se l’agente consiglia il tuo prodotto, lo ignora o sceglie un concorrente.
- Monitora la variazione del punteggio di readiness insieme alle visite generate dagli agenti. L’andamento del punteggio è un indicatore anticipatore; la vera prova sono le visite effettive e le conversioni dal traffico degli agenti.
| Metrica | Cosa registrare |
|---|---|
| Punteggio di readiness | Punteggio da 0 a 100 prima e dopo le correzioni, più gli ID delle regole risolte |
| Vittorie per motore | Se ChatGPT, Perplexity e Gemini hanno consigliato il prodotto sulle stesse query |
| Visite generate dagli agenti | Sessioni attribuite al traffico referral degli agenti, monitorate settimanalmente |
| Conversioni | Ordini completati da sessioni attribuite agli agenti |
Le indicazioni degli esperti su questo tipo di test concordano su un punto: il solo cambiamento del punteggio di readiness non dimostra nulla. Il test onesto è verificare se cambia davvero la raccomandazione dell’agente sulla stessa query, prima e dopo le tue correzioni.
Consiglio pratico: Esegui le query prima/dopo alla stessa ora del giorno e con una formulazione identica. Le risposte degli agenti possono variare da una sessione all’altra anche senza cambiamenti da parte tua, quindi una singola coppia di query non prova nulla. Esegui ogni query tre volte per motore e considera il risultato di maggioranza.
Cosa includere nella checklist di readiness per gli agenti?
Passa in rassegna questo elenco su ogni scheda prodotto prima di intervenire su qualsiasi altra cosa. L’ordine segue la frequenza con cui ogni elemento blocca una raccomandazione da parte di un agente, non la facilità della correzione.
- Nome prodotto, brand e identificatori (GTIN, MPN o SKU) presenti sia nell’HTML sia nel JSON-LD
- Prezzo finale e valuta renderizzati lato server, perfettamente allineati al tuo feed
- Stato della disponibilità aggiornato e coerente tra pagina, schema e feed
- Almeno un’immagine prodotto referenziata nello schema, non solo mostrata visivamente
- Numero di recensioni e valutazione esposti nei dati strutturati, non nascosti in un widget di terze parti
Le sei correzioni che sbloccano più agenti, in ordine approssimativo di frequenza, sono: renderizzare lato server prezzo e disponibilità invece di caricarli via JavaScript, inserire un JSON-LD Product e Offer completo, allineare il feed ai prezzi della pagina live, collegare le policy di spedizione e reso direttamente dalla scheda prodotto, aggiungere un breve blocco FAQ che risponda alle domande più comuni dei clienti e dare all’agente contesto per il confronto (materiali, vestibilità o taglie, cosa rende questa variante diversa da una simile). Dai priorità in base a impatto e sforzo: le correzioni a schema e server-side rendering richiedono un pomeriggio e sbloccano del tutto il recupero dei dati, mentre il contesto comparativo richiede più tempo per essere scritto ma raramente determina se un agente ti trova oppure no.
Confronto tra i principali simulatori di agenti AI per prezzo e profondità
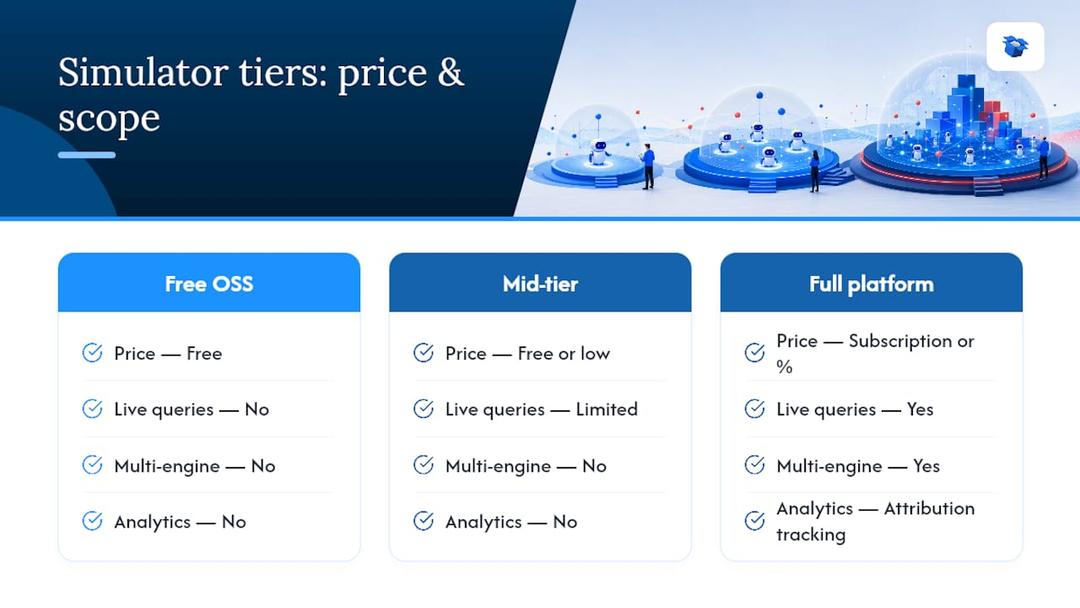
Gli strumenti di simulazione si dividono in tre fasce. Gli auditor gratuiti e open source come CatalogReady forniscono un punteggio deterministico da 0 a 100, ID delle regole e patch JSON-LD, funzionando interamente offline senza richiedere una chiave API. Questo li rende un ottimo primo passo: nessun costo, nessun attrito di registrazione e output su cui puoi intervenire nello stesso giorno. Il compromesso è l’ampiezza del controllo. Un auditor locale verifica schema e server-side rendering, ma non esegue query live su ChatGPT o Perplexity per mostrarti cosa consiglia davvero un agente oggi.
I checker di fascia intermedia, spesso strumenti web gratuiti o a basso costo, eseguono una scansione di una singola pagina e segnalano i blocchi più evidenti, come campi schema mancanti o crawler bloccati. Sono utili per un rapido controllo di buon senso, ma di solito non arrivano ai test cross-engine o al monitoraggio continuo.
Le piattaforme complete, come ecentic, uniscono l’audit deterministico di uno strumento open source alla simulazione live su più motori, ad analisi di attribuzione che tracciano le visite effettivamente generate dagli agenti e alla pubblicazione con un clic delle correzioni in Shopify o WooCommerce. Qui i prezzi sono impostati come abbonamento mensile fisso oppure come percentuale degli ordini attribuibili al traffico degli agenti, con una scansione gratuita come punto di ingresso. La differenza tra le fasce non riguarda davvero l’accuratezza di un singolo controllo. Riguarda piuttosto se stai testando manualmente una sola pagina o eseguendo diagnostica continua su un catalogo mentre monitori se il traffico degli agenti converte davvero.
L’interfaccia dello strumento rende i dati davvero utilizzabili?
Un punteggio di preparazione non serve a nulla se non riesci a trasformarlo in una correzione prima del prossimo lancio di prodotto. I simulatori migliori presentano i risultati come un elenco prioritario, dal problema più grave in giù, con spiegazioni chiare accanto a ogni ID regola invece di un muro di output tecnico.
Gli strumenti open source da riga di comando come CatalogReady richiedono dimestichezza con il terminale e la lettura diretta dell’output JSON: va bene per un membro di un team tecnico, ma crea attrito per un merchant DTC che gestisce da solo il proprio negozio online. Le piattaforme web sacrificano parte di quel controllo diretto in cambio di una dashboard: un punteggio di preparazione ben visibile, un elenco dei controlli non superati sotto di esso e un pulsante o snippet di codice per applicare la correzione invece di una patch manuale da copiare nei file del tema.
Due dettagli dell’interfaccia distinguono uno strumento davvero utile da uno che sembra solo ben rifinito. Primo: ti mostra perché un controllo non è stato superato, con il campo specifico o la riga di markup coinvolta, oppure solo che è fallito? Secondo: puoi rieseguire lo stesso controllo dopo una correzione senza dover riavviare tutta la verifica? Uno strumento che obbliga a una scansione completa per ogni piccola modifica trasforma una correzione da cinque minuti in un ciclo da venti, e la maggior parte dei merchant smette di usarlo dopo il terzo giro. Le piattaforme pensate per un utilizzo continuativo, invece che per una verifica una tantum, tendono a separare “riscansiona tutto” da “ricontrolla solo questa regola”, e conta più di quanto sembri quando gestisci più di una manciata di SKU.
Quanto sono realistiche queste simulazioni rispetto al comportamento reale degli agenti?
La risposta è: abbastanza realistiche da individuare i blocchi strutturali, meno precise nel prevedere i ranking esatti. Un simulatore che controlla dati strutturati, accesso del crawler e coerenza dei prezzi sta verificando gli stessi passaggi meccanici che incontra un agente reale. Se nel tuo JSON-LD manca un campo obbligatorio o il tuo robots.txt blocca PerplexityBot, il risultato è deterministico. Si ripeterà sempre nello stesso modo, in simulazione come in produzione.
Dove la simulazione diventa meno precisa è nel passaggio finale della raccomandazione. Gli agenti valutano freschezza dei contenuti, formulazione della query dell’acquirente e contesto competitivo in modi che cambiano tra sessioni e aggiornamenti dei modelli. Una query che oggi mostra il tuo prodotto potrebbe non farlo domani, anche senza modifiche da parte tua. Per questo un singolo test vittoria/sconfitta dimostra poco. Eseguire la stessa query tre volte per motore e monitorare il risultato prevalente, come spiegato in precedenza, offre una valutazione più affidabile rispetto a un controllo singolo.
Anche i test su più motori contano, perché ChatGPT, Gemini e Perplexity non si comportano allo stesso modo. In particolare, Perplexity privilegia contenuti recenti e citabili e premia attribuzioni chiare, secondo ricerche sui segnali di credibilità orientati agli agenti, che hanno rilevato come aggiungere citazioni, virgolette e statistiche a una pagina possa aumentarne la visibilità nelle risposte generative fino al 40%. Un simulatore che testa un solo motore non rileverà affatto questa differenza, e finirai per ottimizzare i segnali sbagliati senza accorgertene.
Cosa dovresti aspettarti da supporto e documentazione?
Gli strumenti open source come CatalogReady includono un readme su GitHub e l’eventuale attività della community attorno al progetto. Va bene se ti senti a tuo agio nel leggere definizioni di regole nel codice e correggere da solo errori JSON-LD, ma non avrai nessuno a cui chiedere quando una correzione non si comporta come previsto.
Le piattaforme commerciali variano molto sotto questo aspetto, e la differenza emerge subito quando una correzione non funziona. Una buona documentazione per questa categoria significa più di una semplice pagina funzionalità. Significa una spiegazione precisa di cosa controlla ogni ID regola, un esempio di JSON-LD prima e dopo la correzione e un canale di supporto che comprenda il comportamento degli agenti, non solo la SEO ecommerce generica. Un team di supporto capace di spiegare perché PerplexityBot si comporta in modo diverso da OAI-SearchBot vale più di uno che si limita a seguire uno script standard di ticketing.
Chiedi informazioni sulla frequenza degli aggiornamenti prima di scegliere qualsiasi piattaforma. Il comportamento degli agenti cambia quando i provider aggiornano i loro modelli, e uno strumento con documentazione non aggiornata all’attuale versione di ChatGPT Shopping o della ricerca prodotti di Gemini sta testando un bersaglio mobile con una mappa superata. L’approccio della checklist dei dati strutturati approccio, che mantiene le indicazioni di implementazione aggiornate rispetto ai cambiamenti di schema.org, conta qui più che nella maggior parte delle categorie software perché gli agenti sottostanti evolvono più velocemente delle normali linee guida SEO.
Come si presentano le vere correzioni nella pratica?
Il modello che emerge nelle correzioni riuscite è quasi sempre lo stesso: una pagina che sembrava completa a un acquirente umano era in realtà invisibile a un agente per una lacuna specifica e correggibile. Un prezzo mostrato solo dopo una chiamata JavaScript. Un feed che indicava un prodotto come disponibile mentre lo schema della pagina diceva il contrario. Un GTIN mancante che impediva all’agente di completare il confronto prezzi tra retailer.
I merchant che hanno eseguito prima una verifica deterministica, invece di tentare correzioni in stile SEO, hanno riscontrato con continuità che il vero blocco era strutturale, non legato ai contenuti. Riscrivere le descrizioni prodotto raramente risolve un problema di accesso del crawler. Allineare il feed con i prezzi della pagina live sì. I clienti ecentic hanno segnalato aumenti misurabili sia nelle visite generate dall’AI sia nelle vendite complessive dopo aver eseguito questo tipo di verifica e applicato le relative correzioni, in linea con il modello generale: prima correggi il livello leggibile dalle macchine, poi tendono a seguire anche i miglioramenti nel tasso di raccomandazione perché l’agente riesce finalmente a leggere ciò che stai offrendo.
La lezione vale oltre il singolo caso: le incoerenze tra pagina, feed e schema sono un fattore di esclusione più grave di un copy debole. I merchant che inseguono modifiche ai contenuti basate sulle keyword prima di correggere queste discrepanze stanno ottimizzando il livello sbagliato.
Cosa fa davvero la differenza qui?
La maggior parte dei consigli sulla visibilità AI nello shopping la tratta ancora come SEO tradizionale con un nuovo acronimo aggiunto sopra. Non è così. La SEO tradizionale premia segnali di rilevanza accumulati nel tempo. La visibilità presso gli agenti premia la correttezza strutturale che puoi correggere oggi stesso: il tuo JSON-LD viene interpretato correttamente? Il prezzo coincide con quello del feed? Il crawler riesce davvero a raggiungere la pagina? È un problema fondamentalmente diverso, e la maggior parte dei merchant sta ancora cercando di risolvere quello sbagliato.
L’aspetto trascurato è la coerenza, non il contenuto. Una pagina può avere un copy eccellente e comunque perdere contro un concorrente perché il prezzo nel feed non corrisponde a quello sulla pagina. Gli agenti trattano questa discrepanza come un problema di affidabilità e passano oltre. Nessuna scrittura persuasiva può correggere un’incoerenza strutturale tra le tue stesse fonti dati.
Se devi fare una sola cosa per iniziare, esegui una verifica deterministica prima di toccare una sola parola del copy. Correggi ciò che la verifica segnala come problematico, riallinea il feed, poi testa la stessa query su più motori per vedere se la correzione ha davvero cambiato il risultato. Saltare il test della percentuale di vittorie significa ottimizzare sulla fiducia. UCP Playground esiste proprio perché un semplice punteggio di preparazione non ti dice se la raccomandazione reale di un agente è cambiata, e quel divario tra “il punteggio è migliorato” e “l’agente ha scelto me” è il punto in cui molti merchant smettono di guardare troppo presto.
Trasforma il tuo punteggio di preparazione in traffico reale dagli agenti
Eseguire una verifica in autonomia ti dice cosa non funziona. Correggere tutto su un intero catalogo e poi dimostrare che la correzione ha funzionato è il punto in cui la maggior parte dei merchant esaurisce il tempo a disposizione. ecentic chiude questo ciclo: si collega direttamente a Shopify o WooCommerce, esegue gli stessi controlli deterministici descritti sopra sull’intero catalogo e fornisce patch JSON-LD pronte da incollare con ID regola invece di suggerimenti vaghi.

Oltre alla verifica, UCP Playground di ecentic ti permette di simulare come ChatGPT, Gemini, Claude e Perplexity valutano qualsiasi pagina prodotto live e di testare le modifiche prima di pubblicarle. La pubblicazione con un clic applica le correzioni direttamente nel tuo store, mentre le analisi di attribuzione monitorano visite e ordini generati dagli agenti così puoi verificare se una correzione ha davvero modificato la tua percentuale di vittorie, non solo il punteggio di preparazione. I clienti hanno segnalato aumenti misurabili sia nelle visite generate dall’AI sia nelle vendite dopo aver adottato questo workflow.
Se il tuo store usa Shopify, la configurazione specifica per la piattaforma si collega in pochi minuti; i merchant WooCommerce hanno lo stesso percorso di integrazione. Inizia con una scansione gratuita delle tue schede prodotto per vedere il tuo attuale punteggio di preparazione prima di decidere cosa correggere per primo.
Fonti
Per test pratici oltre questo articolo, CatalogReady offre uno strumento gratuito offline di verifica della preparazione con punteggio da 0 a 100 e correzioni pronte da incollare. Checklist per pagine prodotto di CrawlConsole spiega nel dettaglio i campi esatti controllati dagli agenti. Per un contesto più ampio sul ruolo dell’AI nell’ecommerce, la raccolta di casi d’uso AI di BabyLoveGrowth è un buon punto di partenza.
FAQ
Che cos’è un simulatore di agenti AI per gli acquisti?
È uno strumento che ricrea il modo in cui ChatGPT, Gemini o Perplexity leggono e valutano una pagina prodotto, mostrandoti cosa l’agente vede, cosa ignora e perché potrebbe scegliere invece un concorrente.
I simulatori gratuiti di agenti AI sono sufficienti per i piccoli store?
Strumenti di verifica open source come CatalogReady funzionano bene per controllare una singola pagina e non costano nulla, ma non eseguono query live su più motori né monitorano il traffico continuo generato dagli agenti come fa una piattaforma completa.
Con quale frequenza dovrei rieseguire una verifica della preparazione?
Riesegui la verifica dopo qualsiasi modifica a prezzi, inventario o schema e, come minimo, una volta al mese, perché il comportamento degli agenti cambia quando ChatGPT, Gemini e Perplexity aggiornano i loro modelli.
Un simulatore può garantire che il mio prodotto venga consigliato?
Nessuno strumento può garantire un ranking permanente; le raccomandazioni degli agenti cambiano in base alla formulazione della query e agli aggiornamenti dei modelli, quindi considera ogni simulazione come un’istantanea e non come una promessa duratura.
Ecentic funziona sia con Shopify sia con WooCommerce?
Sì, ecentic si collega direttamente sia agli store Shopify sia a quelli WooCommerce e applica le correzioni tramite pubblicazione con un clic dopo una verifica.
Esplora questi argomenti