

L'analisi del traffico guidato da agenti è la pratica di acquisire, classificare e attribuire le richieste effettuate da attori non umani, per poi misurare i compiti che questi agenti completano per conto di soggetti umani. Sostituisce la sessione come unità di misura con un modello più semplice: attore, compito, risultato.
Se nei tuoi dashboard vedi ancora una linea piatta per il “traffico bot” accanto a una quota crescente di visite da agenti AI senza alcun dato di conversione associato, non stai misurando ciò che sta realmente accadendo sul tuo sito. Gli agenti per gli acquisti di ChatGPT, Gemini e Perplexity leggono le pagine prodotto, confrontano le specifiche e passano raccomandazioni ad acquirenti che non scorrono nemmeno oltre la prima schermata. Il tuo stack di analytics probabilmente non sa nemmeno che questo sta succedendo.
Tre mosse correggono rapidamente i punti ciechi più grandi:
- Attiva l'inoltro dei log del CDN o dell'edge per acquisire richieste che non caricano mai un browser né attivano un tag JavaScript.
- Aggiungi una proprietà
actornel punto di ingestione, etichettata come umano, agente o crawler, prima ancora che i dati arrivino a un dashboard. - Instrada questi log in un warehouse invece che in uno strumento lato client, così puoi collegare nel tempo gli eventi degli agenti ai risultati.
Gli agenti consultano spesso i contenuti molto prima di un acquisto, fornendo informazioni a un acquirente che arriva sul sito con una decisione già presa. Sono ricavi che il tuo sistema di analisi tradizionale attribuisce attualmente al traffico “direct” oppure non rileva affatto.
Punti chiave
L'analisi del traffico guidato da agenti funziona quando i team sostituiscono le metriche di sessione con un modello basato su attore, compito e risultato supportato da acquisizione lato server e logging collegato all'identità.
| Punto | Dettagli |
|---|---|
| Acquisisci prima all'edge | L’inoltro dei log della CDN e dell’edge intercetta la maggior parte delle richieste degli agenti che non eseguono affatto JavaScript lato client. |
| Abbandona le metriche di sessione per gli agenti | La frequenza di rimbalzo e la profondità di scroll non significano nulla per gli attori non umani; usa invece attore, compito e risultato. |
| Misura il completamento dei compiti, non le visualizzazioni di pagina | Definisci i criteri di successo per recupero dati, procedura di compilazione di un form e integrazioni prima di riportare qualsiasi metrica di completamento. |
| Colma deliberatamente il divario di attribuzione | I protocolli canary e i log immutabili collegati all'identità riducono l'esposizione legale e di audit derivante da azioni di agenti non autorizzate. |
| Ottimizza ciò che gli agenti leggono davvero | Ecentic simula le valutazioni degli agenti AI per gli acquisti sulle pagine prodotto e riporta i fattori specifici che favoriscono o bloccano le raccomandazioni. |
Che cos’è il traffico generato da agenti e perché le metriche di sessione non funzionano
Oggi tre tipi di attori colpiscono i tuoi server e il loro comportamento non potrebbe essere più diverso. Un essere umano naviga in modo interattivo, con pause, scroll e movimenti del mouse. Un crawler indicizza contenuti per un corpus, di solito senza alcun interesse per un compito specifico. Un agente agisce per conto di una persona, recupera una pagina, estrae dati e spesso completa un’attività come un confronto o un passaggio dell’acquisto, senza mai renderizzare visivamente la pagina.
Le metriche web standard presuppongono che dall’altra parte ci sia una persona. Con gli agenti, questa ipotesi salta subito.
- Frequenza di rimbalzo non significa nulla quando un agente recupera una pagina, estrae il prezzo e la tabella delle specifiche, poi se ne va. È un’attività completata, non una visita abbandonata.
- Tempo sulla pagina non si applica a una richiesta che si conclude in millisecondi, perché non c’è rendering, né lettura, né scroll.
- Profondità di scorrimento richiede una viewport. Gli agenti headless che effettuano chiamate HTTP grezze non ne generano mai una.
La soluzione richiede un modello mentale completamente diverso: attore, attività, esito. Classifichi chi ha effettuato la richiesta, definisci che cosa stava cercando di fare e registri se ci è riuscito. Questo schema funziona sia che l’attore sia un acquirente, un crawler o un agente autonomo che confronta le offerte di cinque concorrenti prima di raccomandarne una a un compratore.
Come funzionano davvero il rilevamento e la registrazione dell’attività degli agenti
La maggior parte dell’attività degli agenti è invisibile agli strumenti di cui i team marketing già si fidano. Questa è la parte scomoda. Google Analytics, i tag di Adobe Analytics e la maggior parte delle configurazioni dei tag manager dipendono dall’esecuzione di JavaScript in un browser. Sempre più spesso il traffico degli agenti salta del tutto questo passaggio.
La registrazione lato server e edge è ciò che intercetta davvero questo traffico. La telemetria dei fornitori mostra che circa il 59% del traffico degli agenti di ChatGPT arriva tramite client HTTP diretti che non eseguono mai uno script, il che significa che gli strumenti di analisi lato client perdono per progettazione, non per errore, più della metà dell’attività. Se tutta la tua strumentazione vive in un tag manager, stai misurando una fetta sempre più piccola di ciò che sta accadendo davvero.
I log di CDN ed edge risolvono questo problema perché registrano ogni richiesta che raggiunge la tua infrastruttura, indipendentemente dal fatto che un browser visualizzi o meno anche un solo pixel. È a questo livello che inizia davvero l’analisi del traffico guidato da agenti.
Una manciata di segnali separa in modo affidabile gli agenti dagli esseri umani e dai bot generici, una volta che osservi i log grezzi:
- Stringhe user-agent dichiarate. Molti agenti si identificano onestamente, almeno per ora, con stringhe che fanno riferimento al modello o alla piattaforma dietro la richiesta.
- Rapporto tra asset e richieste. Quando una persona carica una pagina, scarica decine di immagini, font e script. Un agente che estrae dati strutturati spesso richiede solo l’HTML o un payload JSON.
- Assenza di beacon. Il mancato invio del pixel di analytics su una visualizzazione di pagina che a livello server è chiaramente avvenuta è di per sé un segnale.
- Schemi di header e tempi di richiesta. Gli agenti tendono a richiedere le pagine alla velocità di una macchina, con ordini degli header e un’entropia temporale diversi dal comportamento tipico dei browser.
- llms.txt e asset strutturati. Un numero crescente di siti pubblica ormai un file llms.txt insieme agli schemi OpenAPI, offrendo agli agenti (e ai tuoi log) un’interfaccia documentata e dichiarata con cui confrontare le richieste.
La convalida degli intervalli IP dei modelli dichiarati o il confronto delle stringhe di richiesta con la documentazione pubblicata dai fornitori aggiungono un ulteriore livello di affidabilità, anche se da soli non sono mai infallibili.
Consiglio pratico: Non affidarti solo alle stringhe user-agent. Abbinale a un punteggio basato sul rapporto tra asset richiesti, così anche una stringa falsificata viene segnalata se lo schema delle richieste non corrisponde a una vera sessione del browser.
Le metriche chiave che mostrano davvero l’impatto degli agenti
Analizzare il traffico degli agenti con pageview e sessioni dà agli stakeholder numeri che sembrano impressionanti o allarmanti per i motivi sbagliati. Le metriche che contano tracciano richieste, attività e risultati di business, non le visite.
| Metrica | Cosa ti dice |
|---|---|
| Quota di richieste generate dagli agenti | Percentuale delle richieste totali per pagina e per modello, che rivela quali pagine gli agenti leggono davvero |
| Tasso di completamento delle attività | Se il recupero, il flusso di compilazione di un form o una chiamata di integrazione di un agente si sono conclusi con successo |
| Tasso di passaggio da agente a umano | Quanto spesso una sessione dell’agente si traduce in una visita successiva o in un acquisto da parte di una persona |
| Tasso di blocco/errore per attore | Quanto spesso gli agenti subiscono limitazioni di frequenza, vengono bloccati o ricevono errori rispetto agli utenti umani |
| Costo operativo a livello di modello | Utilizzo dei token, latenza e tasso di errore per ogni modello che raggiunge la tua infrastruttura |
Il completamento di un’attività richiede una definizione chiara prima di poter essere misurato. Un’attività di recupero dati riesce quando un agente estrae i dati che cercava, come il prezzo o la disponibilità. Un’attività di procedura di compilazione di un form riesce quando un processo in più fasi, come l’aggiunta al carrello, si completa senza errori. Un’attività di attività di integrazione riesce quando una chiamata in stile API restituisce una risposta valida e utilizzabile. Definisci tutto questo in anticipo, altrimenti la metrica è rumore privo di significato.
Le conversioni assistite dagli agenti meritano una voce dedicata in ogni report. Le guide che tracciano correttamente questo dato mostrano che il traffico indirizzato dagli agenti può convertire a multipli rispetto al traffico organico generico, una volta isolato e misurato correttamente, invece di essere fatto confluire in una categoria indifferenziata come “altro”. È questo il numero che attira l’attenzione di un CFO, non il volume grezzo di richieste.
- Suddividi la quota degli agenti per singolo modello, non solo in una categoria aggregata “bot”.
- Riporta insieme il tasso di completamento delle attività e il tasso di passaggio. Uno senza l’altro nasconde se il traffico degli agenti stia facendo davvero qualcosa di utile.
- Tieni separati i tassi di blocco ed errore dai tassi di errore degli utenti umani. Un picco qui spesso segnala una regola del firewall configurata male, non traffico malevolo.
Costruire la pipeline: schema, tagging e storage
Implementare l’analisi del traffico guidato da agenti è soprattutto un problema di infrastruttura prima che di analisi. Ecco l’ordine che funziona nella pratica.
- Attiva prima l’inoltro dei log del CDN. Acquisisci campi come timestamp, stringa user-agent completa, percorso della richiesta, codice di risposta, dimensione in byte e qualsiasi dato di fingerprint TLS esposto dal tuo CDN.
- Aggiungi
actoreactor_namein fase di ingestione. Ogni evento viene classificato come umano, agente o crawler e, quando è possibile identificarlo, riceve anche un nome specifico (una stringa che indica il modello o la piattaforma), prima di essere scritto in qualsiasi tabella. - Stratifica la logica di classificazione. Parti dallo user-agent dichiarato, confrontalo con segnali comportamentali come rapporto tra asset e timing, poi conferma con token di autenticazione o chiavi API dove esistono. Nessun singolo segnale dovrebbe reggere da solo l’intera decisione.
- Collega gli eventi degli agenti alle identità umane ovunque possibile. Token di autenticazione, cookie di sessione e ID di correlazione ti permettono di ricollegare l’attività di recupero dati di un agente alla persona che lo ha distribuito, colmando il divario tra “un agente ha visitato” e “ha visitato l’agente di questo cliente”.
- Instrada tutto in un data warehouse, non solo in uno strumento di dashboard. pipeline di analytics degli agenti di BigQuery trasmette in streaming gli eventi di interazione grezzi usando la Storage Write API e supporta la ricostruzione delle tracce a posteriori, un aspetto importante quando devi ricostruire cosa ha fatto davvero un agente tre settimane dopo.
- Organizza lo storage per livelli. Conserva i log grezzi e granulari per una finestra di audit definita, poi campiona o aggrega i dati più vecchi. Conservare per sempre tutti i dati con fedeltà completa è un problema di costi che aspetta solo di emergere, e comunque la maggior parte degli audit richiede solo una finestra recente.
Consiglio pratico: Definisci la finestra di conservazione per gli audit in base al ciclo di contestazione o conformità più lungo che può realisticamente verificarsi, non su un periodo arbitrario di 30 o 90 giorni. Se un chargeback o una verifica normativa può emergere sei mesi dopo, le tue tracce devono restare disponibili per tutto quel tempo.
Colmare il gap di attribuzione
Sapere che un agente ha visitato il tuo sito è una cosa. Dimostrare quale persona o organizzazione ha distribuito quell’agente è un problema molto più complesso, ed è quello che tiene svegli i team di compliance.
Il gap di attribuzione esiste perché la maggior parte delle aziende può registrare che un agente ha eseguito un’azione, ma non dimostrare quale persona l’abbia autorizzata. Questo diventa un rischio legale e normativo concreto nel momento in cui un agente compie qualcosa che un’azienda deve poi smentire o difendere.
Questa è la conclusione centrale di l’analisi di Okta sul rischio di conformità dell’AI, e si applica direttamente a qualsiasi team che sviluppa analisi del traffico guidato da agenti per finalità di audit, non solo ai team di sicurezza.
Una misura pratica che sta guadagnando terreno è il protocollo canary: un approccio mediato dal fornitore in cui le interazioni degli agenti includono un identificatore tracciabile che riconduce all’account di origine. Una ricerca che ha valutato questo approccio su agenti web, di comunicazione e cyber ha rilevato che collega in modo affidabile il comportamento osservato a un account sorgente in contesti non ostili, anche se è realistico aspettarsi delle lacune quando un soggetto cerca attivamente di evitare il rilevamento.
Alcune pratiche operative riducono gran parte della distanza rimanente:
- Tratta i log degli agenti come registri immutabili, non come dati da sovrascrivere o compattare prematuramente.
- Collega ogni evento dell’agente a un’identità quando token, cookie o chiavi API lo rendono possibile.
- Crea un punto di coordinamento stabile tra sicurezza, ufficio legale e fornitori della piattaforma prima che un incidente renda inevitabile la conversazione.
Strumenti e dashboard che funzionano davvero
Non serve costruire tutto da zero. Alcuni strumenti concreti coprono già la maggior parte della pipeline.
- BigQuery Agent Analytics gestisce la pipeline dalla raccolta all’analisi: streaming di eventi grezzi, ricostruzione delle tracce ed esecuzione di valutazioni programmatiche sul comportamento degli agenti su larga scala, un aspetto cruciale quando si superano alcune migliaia di richieste di agenti al giorno.
- La dashboard Agentic Traffic di Adobe offre una vista pronta all’uso una volta configurato l’inoltro dei log CDN, con filtri per distribuzione del traffico, linee di tendenza e principali variazioni positive e negative tra mercati, categorie e singoli agenti.
- Strumenti basati su tag come GA4 mantengono un ruolo utile per misurare il comportamento umano, ma sottostimano costantemente l’attività degli agenti perché gran parte di essa non attiva mai un tag lato client. Un approccio efficace consiste nel affiancare GA4 alla raccolta lato server anziché sostituirla completamente, così da mantenere intatti i report sul comportamento umano aggiungendo sopra il livello degli agenti.
- Le dashboard dei fornitori sono realmente utili per monitorare i trend, ma non sostituiscono un modello di tracciamento basato su data warehouse quando servono valutazioni riproducibili per un audit o un’analisi delle cause radice.
Come il traffico degli agenti cambia prestazioni e pianificazione delle risorse
Le richieste degli agenti impattano l’infrastruttura in modo diverso rispetto al traffico umano, e questo comporta implicazioni concrete sulla capacità che molti team non hanno ancora pianificato.
Un visitatore umano genera un picco di richieste parallele: HTML, poi immagini, font, script e beacon analytics distribuiti nell’arco di alcuni secondi. Un agente che estrae dati strutturati spesso effettua una singola richiesta efficiente per ottenere esattamente ciò che gli serve e poi passa oltre. Sulla carta sembra un carico più leggero, ma su larga scala non lo è. Gli agenti possono colpire lo stesso insieme di pagine ad alto valore, come quelle dei prezzi o le schede prodotto, con un volume e una frequenza che nessun singolo utente umano raggiungerebbe mai, dato che non esiste tempo di lettura tra una richiesta e l’altra.
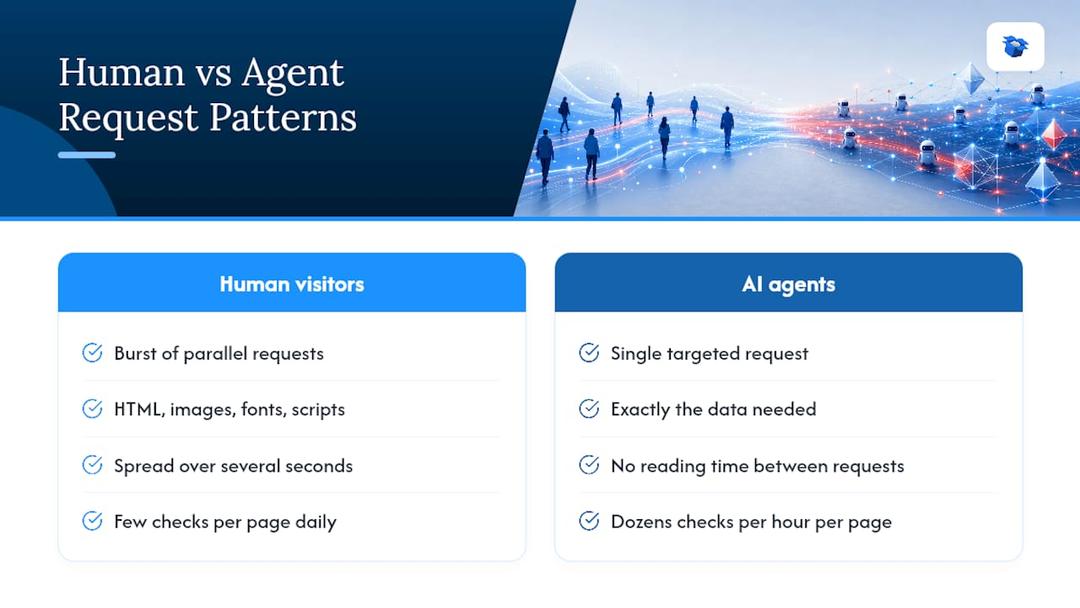
Questo modello si manifesta come un carico inatteso su endpoint specifici invece che come una distribuzione uniforme sul sito. Le decisioni su rate limiting e caching ottimizzate per la navigazione umana possono funzionare male con gli agenti: bloccando traffico legittimo che avrebbe potuto generare una vendita oppure lasciando che un agente mal configurato sovraccarichi un endpoint che il team considerava a basso traffico.
La risposta pratica è trattare il carico generato dagli agenti come una categoria autonoma nella pianificazione della capacità. Monitora i tassi di richiesta per tipo di attore, non solo il traffico aggregato, e configura regole di caching e rate limiting tenendo conto in modo specifico dei modelli di comportamento degli agenti. Una scheda prodotto controllata decine di volte all’ora da agenti per gli acquisti richiede una strategia di caching diversa rispetto a una consultata da utenti umani poche volte al giorno, anche se il numero totale di richieste appare simile in una dashboard aggregata.
Il confine legale ed etico nel monitoraggio del traffico degli agenti
Registrare l’attività degli agenti solleva domande che non hanno ancora risposte definitive, e fingere il contrario è un errore.
Raccogliere dati dettagliati sulle richieste, inclusi header, tempi e fingerprint comportamentali, significa anche acquisire dati che in alcuni casi possono essere ricondotti a persone fisiche, soprattutto quando un agente agisce per conto di un account cliente nominativo. Questo inserisce i log del traffico degli agenti negli stessi quadri normativi sulla privacy che regolano qualsiasi altra raccolta dati dell’organizzazione, che si tratti di una legge regionale sulla privacy o di una policy interna di governance dei dati.
Le questioni etiche procedono di pari passo con quelle legali. Bloccare completamente gli agenti può proteggere le risorse del server, ma può anche escludere un canale di acquirenti in crescita che oggi confrontano i prodotti tramite un agente AI invece che in una scheda del browser. D’altra parte, un accesso troppo permissivo apre la porta ad abusi di scraping mascherati da traffico legittimo di agenti.
Una soluzione equilibrata tratta l’accesso degli agenti come qualsiasi altra integrazione automatizzata: documentata, soggetta a rate limiting e monitorata, con regole chiare su ciò che è consentito. Pubblicare un file llms.txt fa parte di questo approccio, offrendo agli agenti ben progettati un’interfaccia documentata invece di costringerli a dedurre la struttura del sito.
La policy di conservazione è importante quanto quella di raccolta. Conserva i log dettagliati degli agenti solo per il tempo realmente necessario alla finestra di audit o contestazione e applica agli stessi log i medesimi controlli di accesso previsti per qualsiasi altro dataset contenente informazioni comportamentali o collegate all’identità.
Integrare l’analisi degli agenti con sicurezza e rilevamento frodi
L’analisi del traffico degli agenti e il rilevamento delle frodi affrontano problemi sovrapposti, e trattarli come sistemi separati crea punti ciechi da entrambe le parti.
Uno scraper malevolo e un agente AI per gli acquisti legittimo possono apparire quasi identici a livello di rete: richieste automatizzate, nessuna esecuzione JavaScript, stringa user-agent dichiarata o falsificata. L’approccio di classificazione multilivello che identifica gli agenti legittimi, verificando insieme identità dichiarata, segnali comportamentali e autenticazione, è lo stesso che individua gli abusi. Costruire un unico sistema invece di due evita che il team antifrode debba reinventare il rilevamento dei segnali già sviluppato dal team analytics.
L’integrazione pratica parte da una tassonomia condivisa degli attori. Se la tua pipeline analytics etichetta una richiesta come agente, crawler o umano, anche gli strumenti di sicurezza dovrebbero leggere e usare quella stessa etichetta invece di eseguire un proprio layer separato di rilevamento bot con definizioni diverse. Le tassonomie divergenti tra team sono il motivo per cui un agente AI per gli acquisti legittimo viene bloccato da una regola di sicurezza di cui il team analytics non sapeva nulla.
L’altra metà del lavoro è la condivisione degli alert. Un improvviso picco di richieste degli agenti verso un endpoint di checkout potrebbe essere un noto agente per gli acquisti che verifica variazioni di prezzo nel tuo catalogo, oppure un tentativo di credential stuffing mascherato da traffico di agenti. Instradare le anomalie legate agli agenti nello stesso workflow di incident response già usato dalla sicurezza per le frodi, invece che in un alert separato solo analytics che nessuno del team sicurezza monitora, è ciò che permette davvero di individuare la differenza in tempo utile.
Come cambiano le priorità dell’analisi degli agenti nei diversi settori
Non tutti i settori richiedono la stessa attenzione all’interno di un sistema di analisi del traffico guidato da agenti, e trattarlo come un modello universale fa perdere tempo di sviluppo sui segnali sbagliati.
I siti ecommerce e retail danno priorità soprattutto al completamento delle attività su pagine prodotto e prezzi, oltre al tasso di passaggio dall’agente all’umano, perché è questa la metrica che collega direttamente l’attività degli agenti ai ricavi. Il principale punto cieco per un retailer è spesso rappresentato dalle pagine dei prezzi colpite intensamente dagli agenti di comparazione senza alcun monitoraggio delle conversioni corrispondente.
I siti media ed editoriali attribuiscono più peso alla distinzione tra crawler e agenti, perché la questione di business riguarda spesso licenze e riutilizzo dei contenuti più che le conversioni. Distinguere un crawler che costruisce un corpus da un agente che recupera un singolo articolo per rispondere a una domanda specifica dell’utente cambia il modo in cui quel traffico dovrebbe essere valutato e regolato.
Le piattaforme software B2B e SaaS tendono a dare priorità alla categoria delle attività di integrazione, perché gli agenti che interagiscono con questi siti eseguono spesso chiamate in stile API per conto di un altro sistema invece che di un singolo acquirente umano. In questo contesto contano più i tassi di errore e blocco per attore che il tasso di handoff, perché l’“umano” all’altro capo può essere diversi passaggi distante dalla richiesta stessa.
I siti di servizi finanziari sono quelli più vicini ai problemi di attribuzione e governance descritti in precedenza, perché l’esposizione normativa legata ad azioni non autorizzate degli agenti è massima in questo settore. L’approccio di attribuzione basato su canary e il logging immutabile qui contano più che in quasi qualsiasi altro verticale.
Cosa dovrebbero davvero cambiare i team analytics
Mantieni invariati i report predefiniti orientati agli utenti umani. Non ricostruire una dashboard di cui il team marketing già si fida solo per forzare dentro i dati degli agenti. Crea invece una vista parallela, autorizzata ad apparire diversa perché misura qualcosa di strutturalmente diverso.
Il cambiamento organizzativo più importante riguarda il posto che la telemetria degli agenti occupa nella gestione quotidiana. Deve entrare nelle conversazioni su incident response e procurement, non restare nascosta in una presentazione trimestrale analytics che nessuno legge finché qualcosa non si rompe. E se hai intenzione di investire tempo di sviluppo per ottimizzare qualcosa prima di tutto per la leggibilità da parte degli agenti, concentrati su prezzi e pagine prodotto. È lì che gli agenti prendono davvero decisioni per conto degli acquirenti, ed è lì che il ritorno di quel lavoro emerge più rapidamente.
— Xhurian
Trasformare la visibilità degli agenti in schede prodotto ottimizzate
Misurare il traffico degli agenti ti dice che gli agenti stanno leggendo le tue pagine prodotto. Non ti dice perché un agente abbia consigliato un concorrente invece di te, ed è esattamente questo il gap che ecentic colma.

ecentic si collega direttamente al tuo negozio Shopify o WooCommerce e simula il modo in cui ChatGPT, Gemini, Claude e Perplexity valutano realmente le tue schede prodotto rispetto a quelle dei concorrenti, restituendo diagnosi in linguaggio semplice su ciò che ti sta facendo perdere una raccomandazione. I clienti che utilizzano gli strumenti di ottimizzazione di ecentic hanno segnalato aumenti significativi sia nelle visite guidate dall’AI sia nelle vendite dopo aver implementato le riscritture delle schede prodottosuggerite. Invece di limitarti a contare le richieste degli agenti, ottieni un profilo UCP validato per la leggibilità da parte degli agenti e un ciclo di nuova scansione che monitora nel tempo il tuo tasso di selezione man mano che i modelli cambiano.
Se stai già inoltrando i log CDN e classificando gli attori, il pezzo mancante è capire cosa fare con questa visibilità. Esegui una scansione introduttiva gratuita del tuo negozio e scopri esattamente come si posizionano le tue schede prodotto presso gli agenti che le stanno già leggendo.
FAQ
Che cos’è l’analisi del traffico guidato da agenti?
È la pratica di acquisire, classificare e attribuire le richieste effettuate da agenti AI che agiscono per conto di persone, misurando poi le attività completate invece di basarsi su metriche fondate sulle sessioni.
Perché le metriche di sessione non funzionano per il traffico degli agenti?
Metriche come frequenza di rimbalzo e tempo sulla pagina presuppongono che una persona stia caricando e leggendo la pagina, ma gli agenti spesso effettuano una singola richiesta efficiente e se ne vanno, rendendo quei numeri privi di significato.
Come si rileva il traffico degli agenti AI su un sito web?
La raccolta dei log lato server e CDN, combinata con l’analisi dello user-agent, i rapporti tra asset e richieste e la validazione di llms.txt, permette di identificare in modo affidabile l’attività degli agenti che gli strumenti lato client non rilevano.
Che cos’è il gap di attribuzione nell’analisi degli agenti?
È la difficoltà nel dimostrare quale persona o organizzazione abbia autorizzato l’azione di uno specifico agente, creando rischi legali e di conformità che protocolli basati su canary e logging immutabile aiutano a ridurre.
ecentic può aiutare nell’ottimizzazione del traffico degli agenti?
Sì. ecentic simula il modo in cui gli agenti AI per gli acquisti valutano le schede prodotto nei negozi Shopify e WooCommerce e fornisce raccomandazioni specifiche per migliorare visibilità e conversioni guidate dagli agenti.
Esplora questi argomenti