

Fare A/B testing per l'AI significa eseguire confronti controllati tra le varianti delle tue schede prodotto per vedere quale versione ChatGPT, Gemini, Claude o Perplexity consiglia davvero a un acquirente. Inizia simulando alcuni dei tuoi SKU principali rispetto a questi agenti, poi correggi le due cose che compromettono più test ancora prima di partire: dati strutturati mancanti e campi del feed non aggiornati. Dai priorità prima di tutto alla completezza dello schema, all'aggiornamento del feed e alla profondità delle recensioni, perché sono questi i tre segnali che pesano di più in ciò che un agente mostra.
In breve:
- Campi dei dati strutturati come priceValidUntil, deliveryTime e merchantReturnDays sono spesso mancanti o non aggiornati e incidono in modo significativo sulle raccomandazioni degli agenti.
- L'aggiornamento del feed e gli aggiornamenti in tempo reale sono fondamentali, perché prezzi o disponibilità non aggiornati possono causare schede prodotto non corrispondenti e vendite perse.
- I test dovrebbero concentrarsi sull'isolamento di specifiche variabili dello schema o del feed, non su modifiche casuali al copy, perché i segnali degli agenti sono guidati principalmente dai dati.
- Le varianti devono essere testate su più modelli perché agenti AI diversi hanno preferenze distinte per posizionamento e attributi.
- Gli audit basati su simulazioni, eseguiti prima della messa in produzione, possono individuare rapidamente le lacune nei dati strutturati, migliorare la visibilità nei sistemi AI e aumentare il traffico proveniente da persone con una forte intenzione d’acquisto.
Perché i test A/B orientati agli agenti AI contano per i negozi Shopify e WooCommerce
Gli agenti AI per gli acquisti non navigano come fanno le persone. Leggono segnali leggibili dalle macchine: dati strutturati, accuratezza dei feed e conferme di terze parti come recensioni e citazioni editoriali. Una pagina che appare ottima a un cliente umano può essere invisibile per un agente se il markup sottostante è carente.
La Columbia Business School ha eseguito sessioni di acquisto simulate e ha scoperto che posizionamento, badge, prezzo e valutazione cambiavano i prodotti scelti dagli agenti. Modelli diversi avevano preferenze diverse. GPT-4.1 tendeva verso gli articoli posizionati a sinistra nei risultati, Claude privilegiava il centro, Gemini la destra. Questo da solo dimostra che non esiste una singola scheda prodotto “migliore” valida per ogni agente. Esiste per modello, ed è esattamente il motivo per cui testare funziona meglio che tirare a indovinare.
Per i merchant il ritorno è concreto. Il traffico che arriva tramite un agente AI tende ad avere un’elevata intenzione d’acquisto, perché il cliente ha già ricevuto una raccomandazione prima di arrivare sulla tua pagina. Il problema è che la scheda prodotto deve confermare ciò che l’agente ha dichiarato. Se l’agente dice “resi gratuiti entro 30 giorni” e la tua pagina non lo supporta con testo visibile o schema, perdi la vendita in partenza.
Cosa valutano di più gli agenti:
- Completezza dei dati strutturati nei tipi di schema Product, Offer e Review
- Aggiornamento dei feed, cioè prezzi e disponibilità allineati a quanto è effettivamente online sul sito
- Conferme indipendenti tramite recensioni, valutazioni distribuite su più piattaforme e copertura editoriale
Cosa testare: attributi, campi schema e segnali off-site
Prima di eseguire qualsiasi esperimento, definisci esattamente quali campi e segnali vale la pena modificare. Testare modifiche casuali ai testi fa perdere tempo. Testare i campi che gli agenti analizzano davvero no.
- Campi JSON-LD principali. Gli agenti leggono
Product,Offer,AggregateRating, eReview. All’interno diOffer,priceValidUntilconta più di quanto molti merchant pensino, così comeShippingDeliveryTime.deliveryTimeeMerchantReturnPolicy.merchantReturnDays. Un audit di Sellarix su 36 pagine prodotto ha rilevato la presenza di Product JSON-LD nel 72% delle pagine, mapriceValidUntilsolo nel 6%, i tempi di consegna nell’11% e i giorni per il reso appena nel 6%. Nessuna delle pagine analizzate conteneva tutti e tre. - Integrità di feed e protocolli. La completezza del feed Merchant Center, la compatibilità con i protocolli del commercio con agenti AI (ACP, UCP, MCP) e la frequenza di aggiornamento determinano tutti se i dati di un agente corrispondono davvero al tuo sito live, come spiegato in questo playbook Ecommerce AI SEO. Un feed aggiornato una volta al giorno può compromettere silenziosamente un esperimento se il prezzo cambia durante il test.
- Conferme off-site. Volume, recenza e specificità delle recensioni hanno più peso di una semplice valutazione a stelle. Le recensioni sindacate tra partner retail e qualsiasi menzione editoriale aggiungono conferme che un agente può confrontare tra loro.
Ogni variante che crei dovrebbe isolare una di queste tre categorie. Cambia lo schema, non il testo. Cambia il testo, non la frequenza di aggiornamento del feed. Mescolare variabili è il modo in cui i merchant finiscono con risultati che non sanno spiegare.
Come si esegue un test A/B per agenti AI per gli acquisti?
Eseguire questo tipo di test assomiglia meno a uno split test marketing e più a un rollout tecnico controllato. Questa è la sequenza che mantiene i risultati puliti.
- Scegli gli SKU da testare e definisci subito il successo. Scegli da 3 a 5 prodotti che generano fatturato, non l’intero catalogo. Definisci le metriche di successo prima di iniziare: quota di visibilità AI (quanto spesso il tuo prodotto compare quando un agente riceve una richiesta di raccomandazione nella tua categoria), frequenza di citazione e aumento delle conversioni dalle sessioni provenienti da agenti.
- Progetta varianti a variabile singola. Crea una versione con una correzione dello schema (ad esempio aggiungendo
merchantReturnDays), una con specifiche riordinate nella descrizione, una con un estratto di recensione evidenziato. Non combinare mai due modifiche nella stessa variante. - Simula prima di andare live. Esegui ogni variante in sessioni rappresentative di agenti su almeno due famiglie di modelli. A questo punto i bias specifici dei modelli sono ben documentati, e una variante che vince con un modello può perdere con un altro.
- Convalida live, con attenzione. Una volta che la simulazione indica un probabile vincitore, distribuiscilo tramite invii scaglionati del feed o, dove la tua piattaforma lo supporta, in un ambiente sandbox ACP/UCP. Evita di spostare il 100% del traffico già dal primo giorno.
- Gestisci i dettagli tecnici. Su Shopify o WooCommerce, esegui il rendering del JSON-LD lato server invece di iniettarlo tramite un tag manager, assegna GTIN specifici per variante in modo che agenti e feed non uniscano due versioni in un unico prodotto, e scrivi un test di integrazione che verifichi la presenza dei campi critici per gli agenti nella risposta HTML grezza, non solo in un’anteprima dev.
Suggerimento: Esegui di nuovo la simulazione ogni volta che modifichi il tema, lo schema del feed o l’app che gestisce le recensioni. Un aggiornamento del template può rimuovere silenziosamente un blocco JSON-LD che ha richiesto settimane di lavoro.
Strumenti come la funzionalità di scheda prodotto di ecentic possono ridurre notevolmente il tempo necessario per il passaggio 5: individuano i campi mancanti e applicano la correzione al tuo negozio in un solo passaggio, senza richiedere un audit manuale.
Quali metriche indicano davvero che una variante ha vinto?
Le vanity metric qui non contano. Quello che importa è se un agente ha mostrato il tuo prodotto e se quella visita generata dall’agente ha convertito.
KPI principali da monitorare:
- Quota di visibilità AI: quanto spesso il tuo brand compare in un insieme definito di prompt di test rispetto ai concorrenti
- Frequenza di citazione: quanto spesso un agente fa riferimento alla tua specifica pagina prodotto o ai suoi attributi
- Tasso di conversione dei referral da agenti: conversione delle sessioni provenienti da un referrer di agenti noto, tracciate separatamente dal traffico organico e a pagamento
Le metriche di integrità tecnica contano altrettanto, perché un feed difettoso può compromettere una variante altrimenti vincente:
- Tasso di copertura dello schema nel catalogo
- Tasso di accettazione e rifiuto del feed in Merchant Center
- Tasso di presenza di
priceValidUntil,deliveryTime, emerchantReturnDays
Configura un segmento GA4 per i referrer agenti conosciuti come perplexity.ai, chatgpt.com e copilot.microsoft.com, quindi crea un funnel di conversione separato per quel segmento invece di includerlo nel traffico organico generale.
Le dimensioni dei campioni sul traffico referral degli agenti tendono a essere ridotte all’inizio, il che significa che molti test inizialmente risulteranno statisticamente inconcludenti. Considera una singola settimana di risultati piatti come un dato nullo, non un fallimento, e aspetta un pattern su almeno due cicli completi di simulazione e validazione live prima di distribuire una variante all’intero catalogo.
Errori comuni, controlli e suggerimenti
La maggior parte dei test falliti deriva da una manciata di errori ricorrenti:
- Caricamento del prezzo lato client. Se il prezzo viene caricato tramite JavaScript dopo il rendering iniziale della pagina, alcuni agenti non lo vedranno mai e il prezzo nel feed finirà per divergere dal prezzo live.
- Identificatori mancanti per variante. Senza GTIN distinti, un agente (o il tuo stesso feed) unisce due varianti di test in un’unica scheda prodotto.
- Parità del feed compromessa. Il tuo sito mostra un prezzo, il feed un altro, e l’agente sceglie quello di cui si fida di meno.
- Campi di reso o consegna specificati in modo errato. Un
MerchantReturnPolicyche non corrisponde alla tua policy reale erode rapidamente la fiducia quando un cliente se ne accorge.
Crea un test di integrazione automatico per ogni template prodotto che controlli la presenza di questi campi nella risposta server, non nel DOM renderizzato. Intercetta le regressioni prima che un aggiornamento del template elimini silenziosamente sei settimane di lavoro sullo schema.
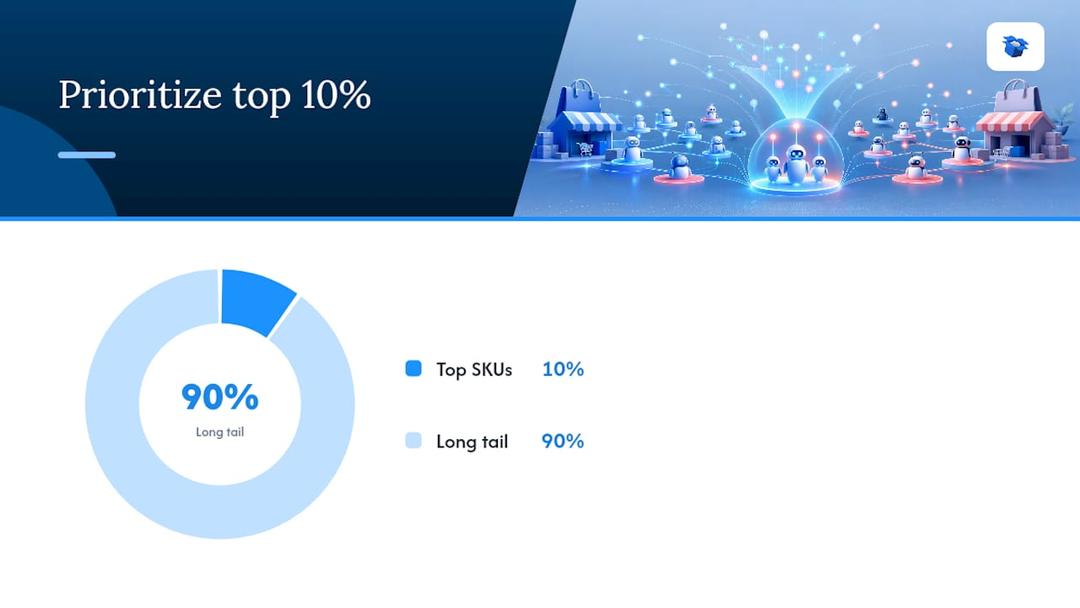
Suggerimento: Dai priorità agli SKU che generano fatturato. Correggi il primo 10% del tuo catalogo per fatturato prima di toccare la long tail. Inoltre, fai ai recensori una domanda specifica (“Per cosa l’hai usato?”) invece di una richiesta generica di valutazione a stelle. Sono le recensioni specifiche per scenario che un agente recupera davvero.
Cosa cambia davvero con i test basati sulla simulazione
Eseguire decine di audit delle pagine prodotto e sessioni simulate di agenti cambia il modo in cui pensi a una scheda prodotto “vincente”. L’istinto è scrivere testi migliori. La realtà è che la maggior parte delle sconfitte deriva da un campo mancante in un blocco schema che nessuno controllava da otto mesi.
Un approccio che esegue sessioni simulate di agenti su ogni scheda prodotto prima della pubblicazione e poi applica le correzioni a Shopify o WooCommerce in un unico passaggio invece di aprire ticket di sviluppo per settimane può aiutare i merchant a migliorare le visite generate dall’AI e le vendite successive una volta colmate le lacune.
— Xhurian
Esegui il tuo primo test A/B con ecentic
Alcune piattaforme trasformano il flusso di lavoro descritto sopra in uno strumento utilizzabile rapidamente. Simulano le tue schede prodotto rispetto a ChatGPT, Gemini, Claude e Perplexity, spiegano in linguaggio semplice perché la scheda di un concorrente ha vinto un confronto e applicano la correzione a Shopify o WooCommerce con un clic, senza ticket di sviluppo o attese per il deploy di un template.

Invece di controllare manualmente priceValidUntil o merchantReturnDays nel catalogo, ricevi una diagnostica che segnala esattamente quali campi critici per gli agenti mancano, seguita da un passaggio di ottimizzazione automatica che li corregge. Le nuove scansioni continue monitorano se il tuo tasso di selezione con ogni agente aumenta dopo ogni modifica, così non devi indovinare se una correzione ha funzionato. Inizia con una scansione gratuita, scegli tre SKU che generano fatturato reale, esegui la simulazione e pubblica la variante vincente. I piani partono da $14.90 al mese con il piano Compete, con Scale e Dominate disponibili man mano che crescono il tuo catalogo e le tue ambizioni.
FAQ
Quanto dura un test A/B per agenti AI?
Un ciclo di simulazione può richiedere uno o due giorni una volta create le varianti, poiché non dipende dal volume di traffico live. La validazione live richiede più tempo, in genere da due a quattro settimane, perché le dimensioni dei campioni di referral dagli agenti sono ancora ridotte per la maggior parte degli store.
Ho bisogno di risorse di sviluppo per eseguire questi test?
Serve qualcuno che sappia modificare JSON-LD e dati del feed, ma una piattaforma come ecentic elimina gran parte del lavoro manuale di coding identificando le lacune e pubblicando direttamente le correzioni su Shopify o WooCommerce.
Quali campi schema contano di più per gli agenti AI?
Offer.priceValidUntil, ShippingDeliveryTime.deliveryTime, e MerchantReturnPolicy.merchantReturnDays sono i tre campi che gli audit trovano più spesso mancanti, anche negli store con uno schema Product altrimenti solido, secondo l’audit di Sellarix.
Posso testare varianti di prodotto diverse per modelli AI diversi?
Sì, e dovresti farlo. Le simulazioni mostrano preferenze specifiche per modello, il che significa che una variante che vince con un agente può perdere con un altro; per questo vale la pena testare almeno due modelli prima del rollout live.
Quanto costa ecentic?
Il piano Compete di Ecentic parte da $14.90 al mese, con Scale a $44.90 e Dominate a $149, oltre a un’opzione con commissione sulle performance del 3% per ordine attribuito all’AI per una tariffazione pay-as-you-go. È disponibile una scansione gratuita prima di impegnarsi in un piano.
Esplora questi argomenti